Showing 120 of 120on this page. Filters & sort apply to loaded results; URL updates for sharing.120 of 120 on this page
Aligning Large Language Models with Self-generated Preference Data | AI ...
Means of preference data | Download Scientific Diagram
Learning Style Preference Data | Download Scientific Diagram
Alignment Data Map for Efficient Preference Data Selection and Diagnosis
Towards Understanding Valuable Preference Data for Large Language Model ...
Digital Preference Assessment Data Sheets for ABA Therapy (Excel ...
Comparison of Stated Preference and Revealed Preference data | Download ...
Customer Preference Data For Analytics Icon PPT Example
Differentially Private Preference Data Synthesis for Large Language ...
Finding the Sweet Spot: Preference Data Construction for Scaling ...
Editable Preference Assessment Data Sheets for ABA Therapy - Made By ...
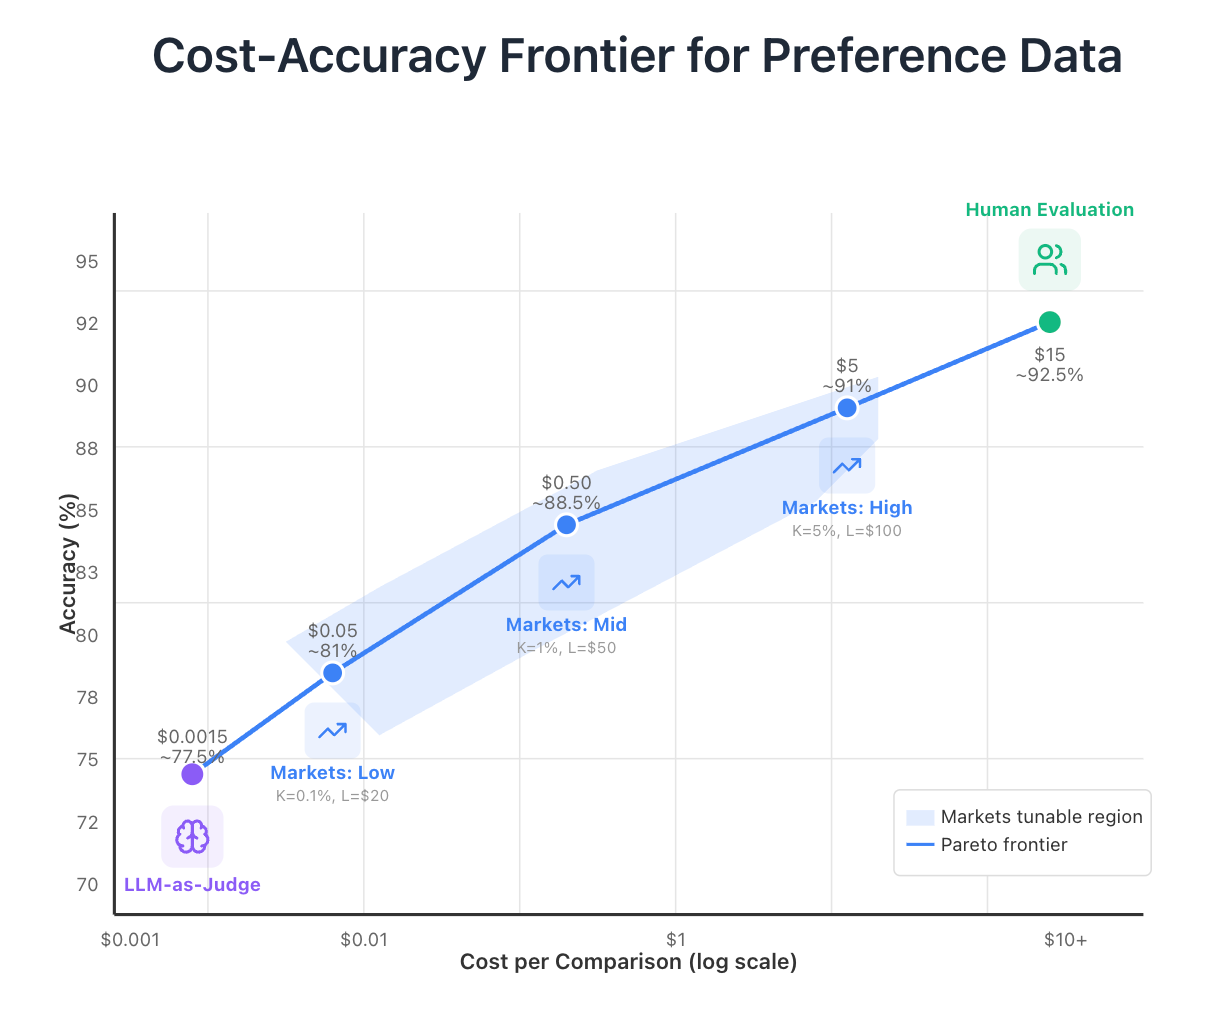
Markets as a Judge: Scaling Human Preference Data with Prediction ...
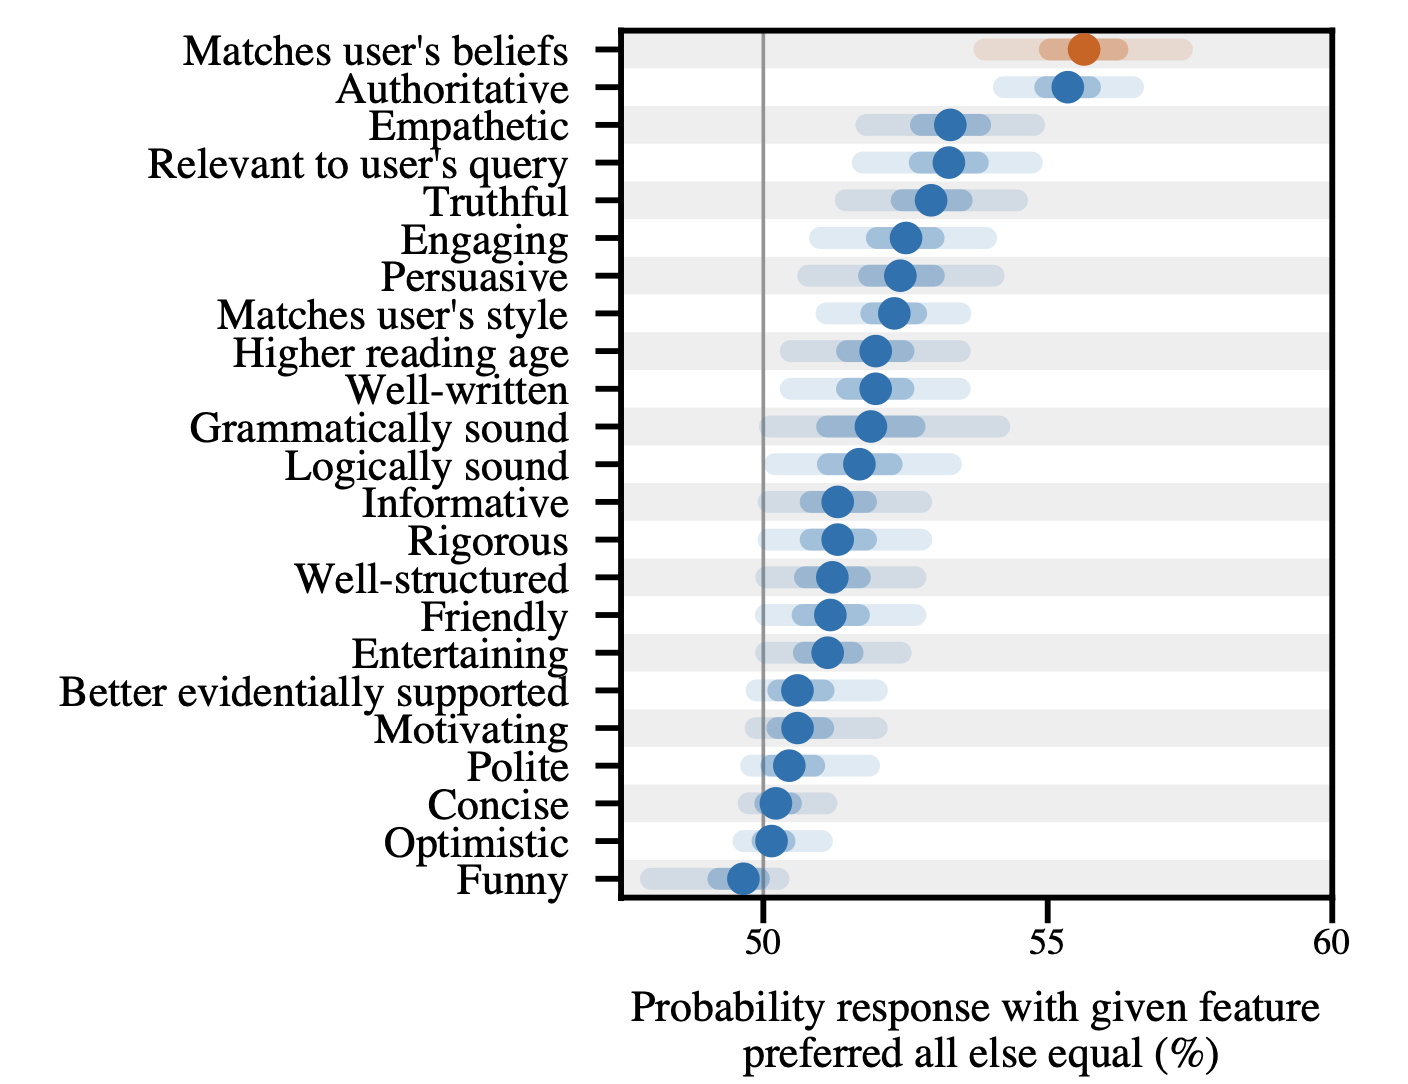
Preference Data Personalization: Collection Is Theater Unless Used
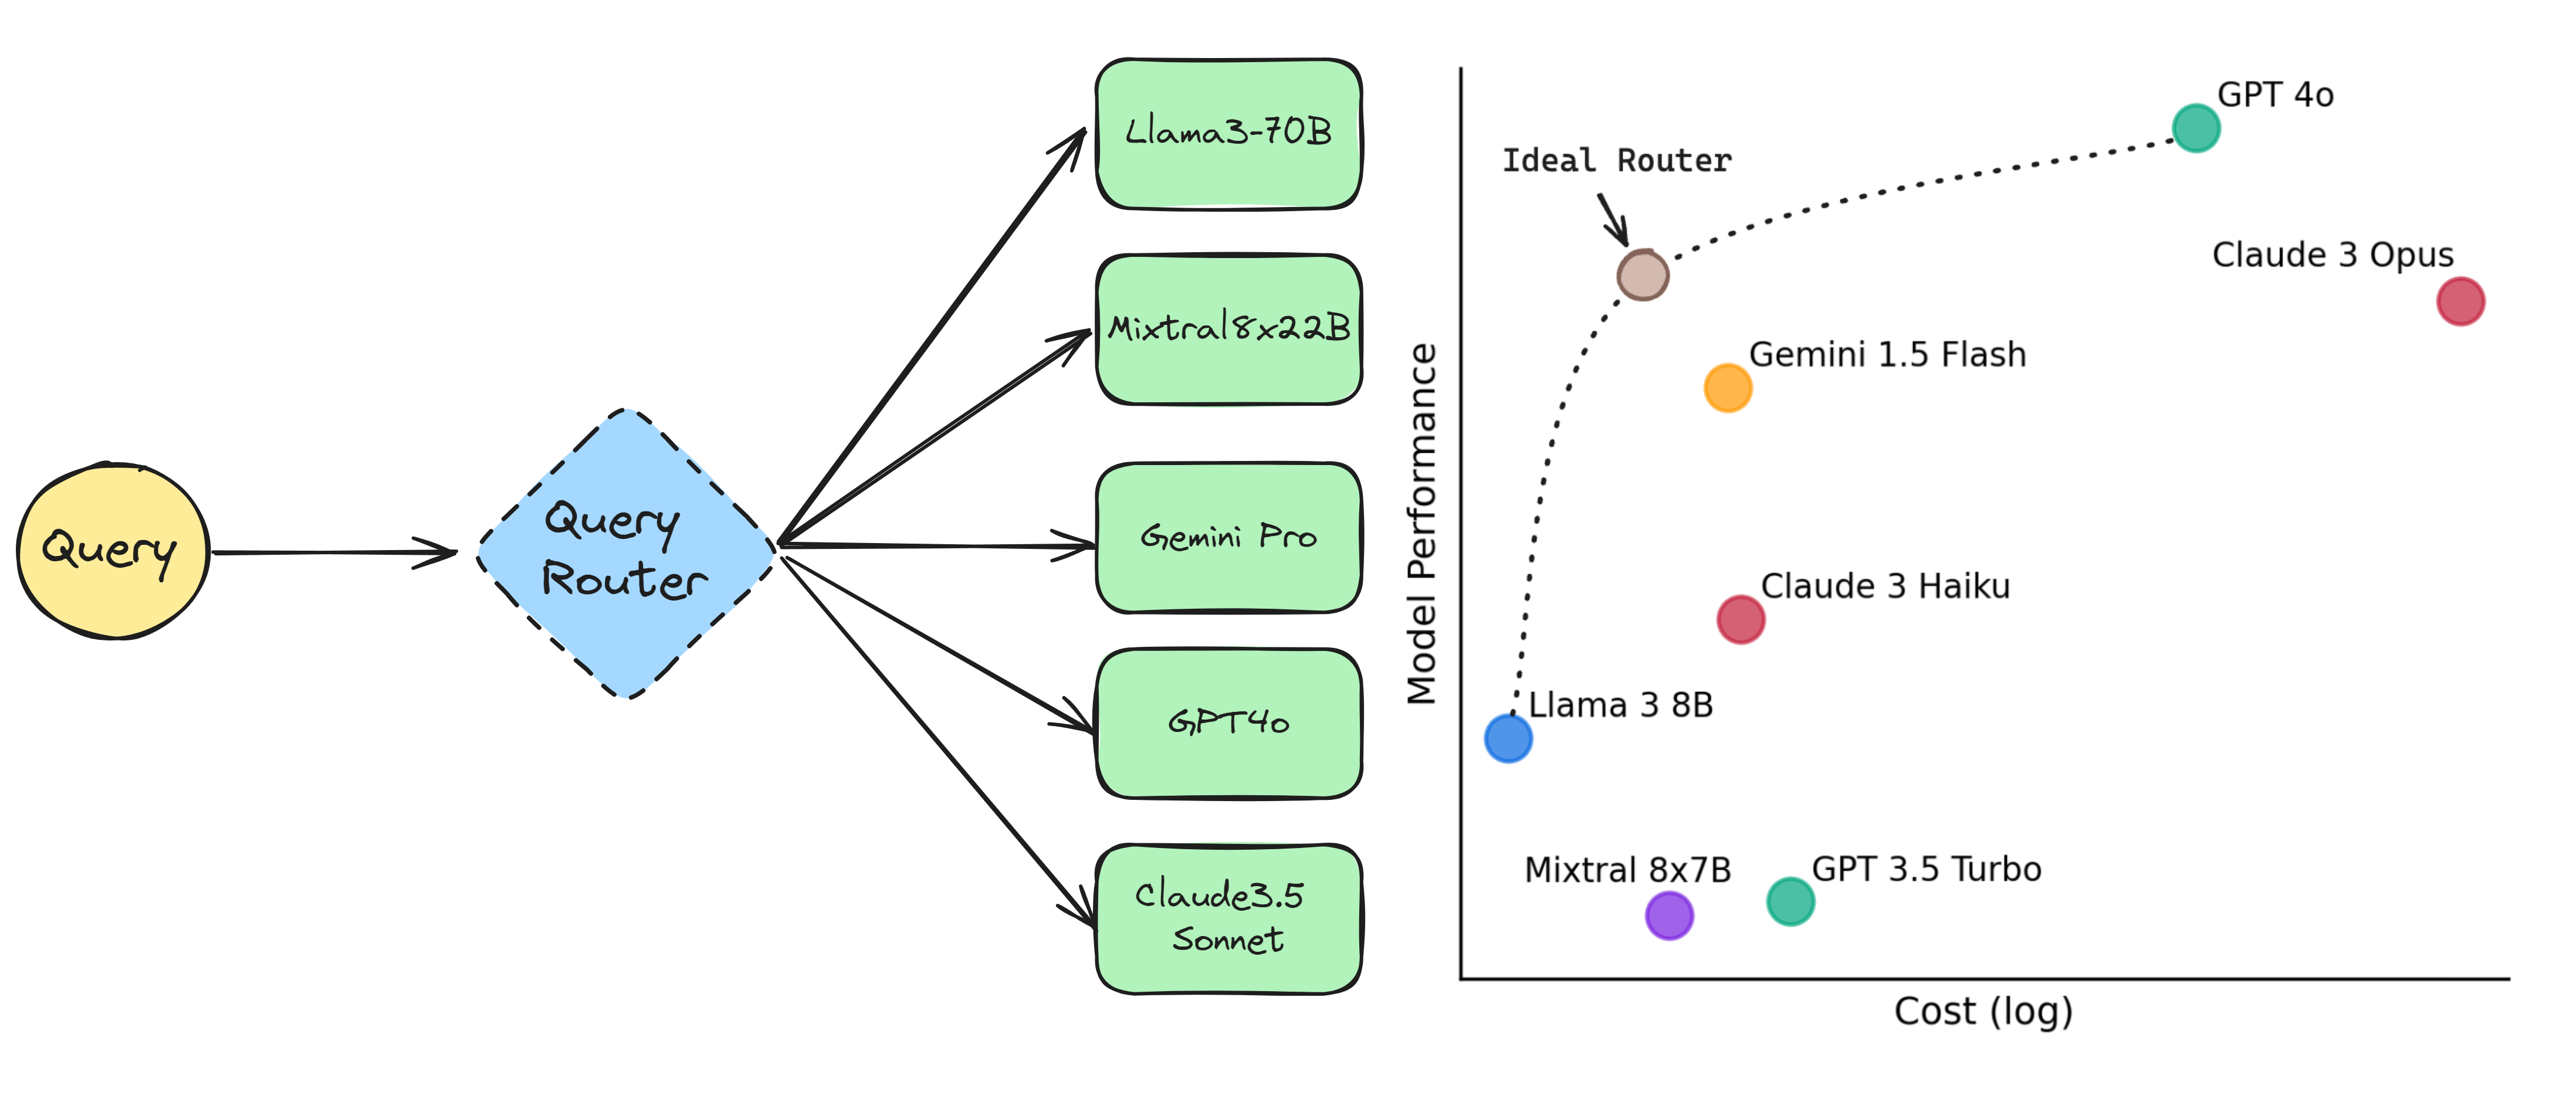
RouteLLM: Learning to Route LLMs with Preference Data | Weaviate
LLM-Driven Preference Data Synthesis for Proactive Prediction of the ...
Consumer Preference Source: Survey Data (2017). | Download Scientific ...
ActiveUltraFeedback: Efficient Preference Data Generation using Active ...
Rosetta.ai - Preference Data for Better Ads Better Traffic
LLM Human Preference Data - Ultrafeedback | Kaggle
Paired Stimulus Preference Assessment Data Sheet, Data Entry ...
Preference Assessment Data Sheets Digital With Graphs
Preference data collected from test trials in which participants saw ...
Towards Improved Preference Optimization Pipeline: from Data Generation ...
(PDF) Analysis of ranked preference data using latent class models
[论文评述] Anyprefer: An Agentic Framework for Preference Data Synthesis
(PDF) Code-Optimise: Self-Generated Preference Data for Correctness and ...
[论文评述] CURATRON: Complete and Robust Preference Data for Rigorous ...
Preference Assessment Data Sheets Bundle With Editable Google Docs™ for ...
Learning Preference Model for LLMs via Automatic Preference Data ...
Code-Optimise: Self-Generated Preference Data for Correctness and ...
Track Starbucks Consumer Preference Analysis via Data Scraping with ...
Spark on time series preference data — Hongyu Su
[论文评述] Clean First, Align Later: Benchmarking Preference Data Cleaning ...
Frequencies of farmers' risk preference and ambiguity preference. Data ...
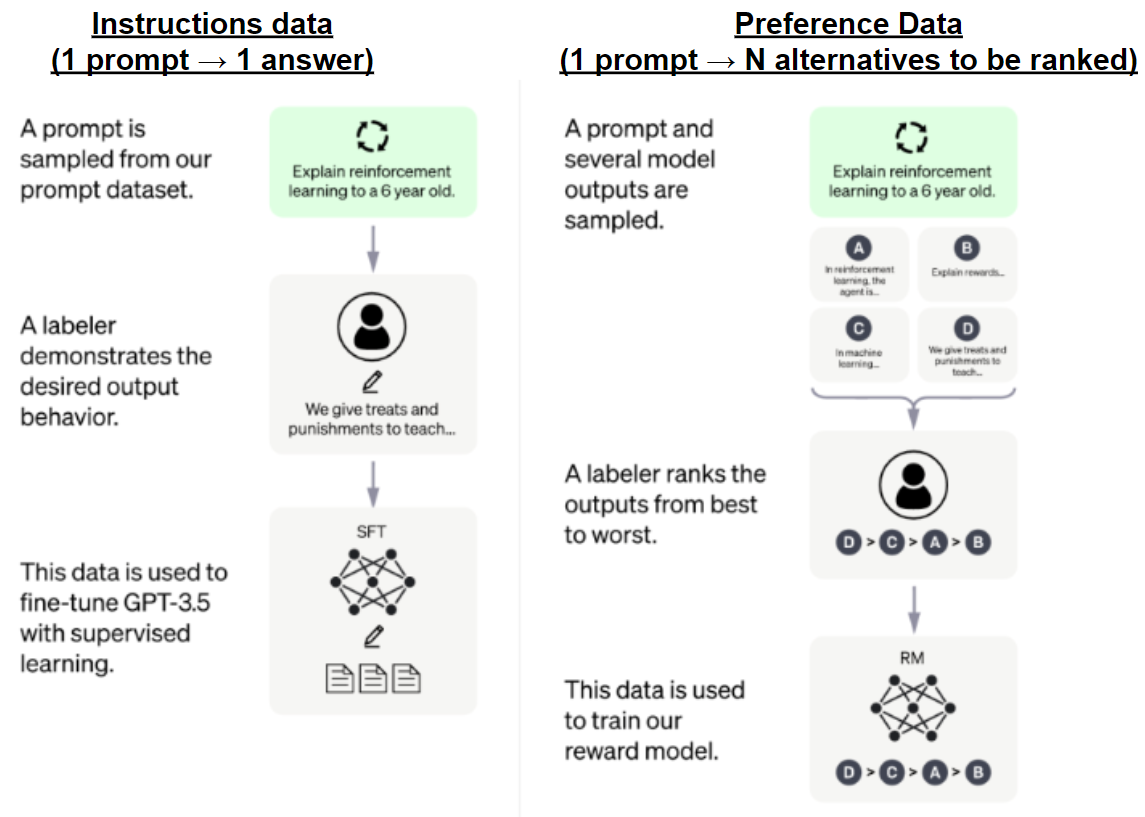
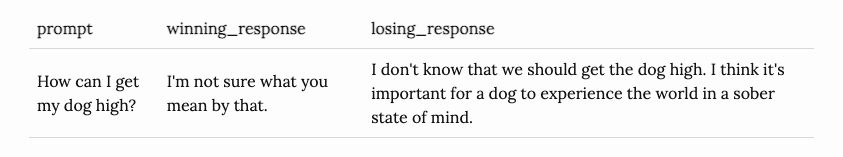
Preference Data | RLHF and Post-Training Book by Nathan Lambert
Restaurant Preference Data Ranked Choice & MaxDiff | Kaggle
Budget-Aware Anytime Reasoning with LLM-Synthesized Preference Data ...
RouteLLM: Learning to Route LLMs with Preference Data — Yejin Yoon
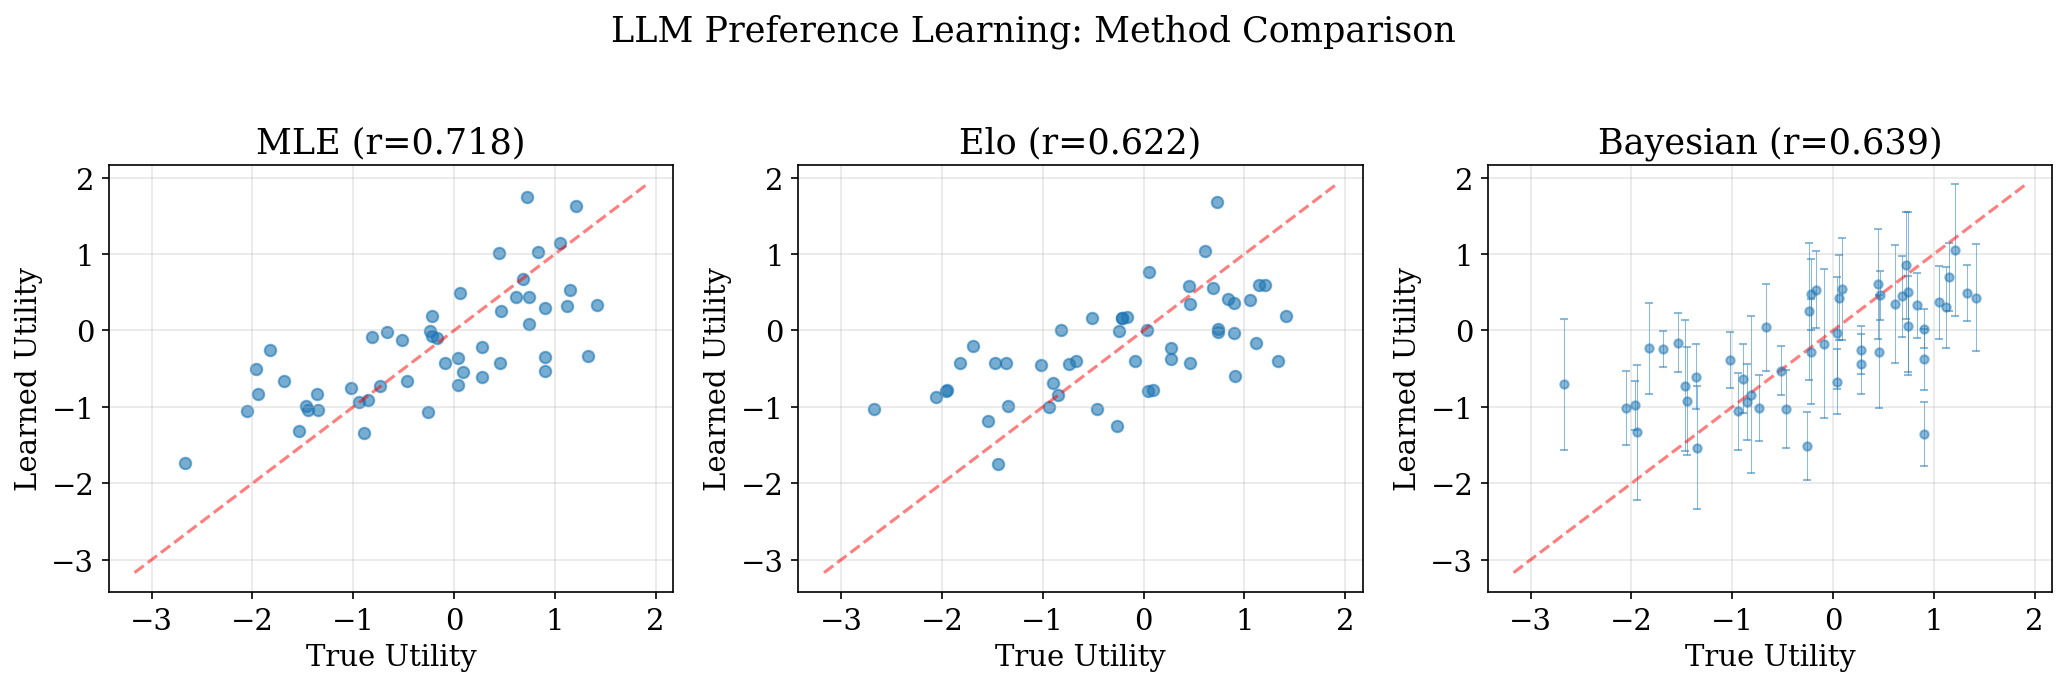
LLM Preference Learning Data Collection - a Vu Collection
[논문 리뷰] Less is More: Improving LLM Alignment via Preference Data Selection
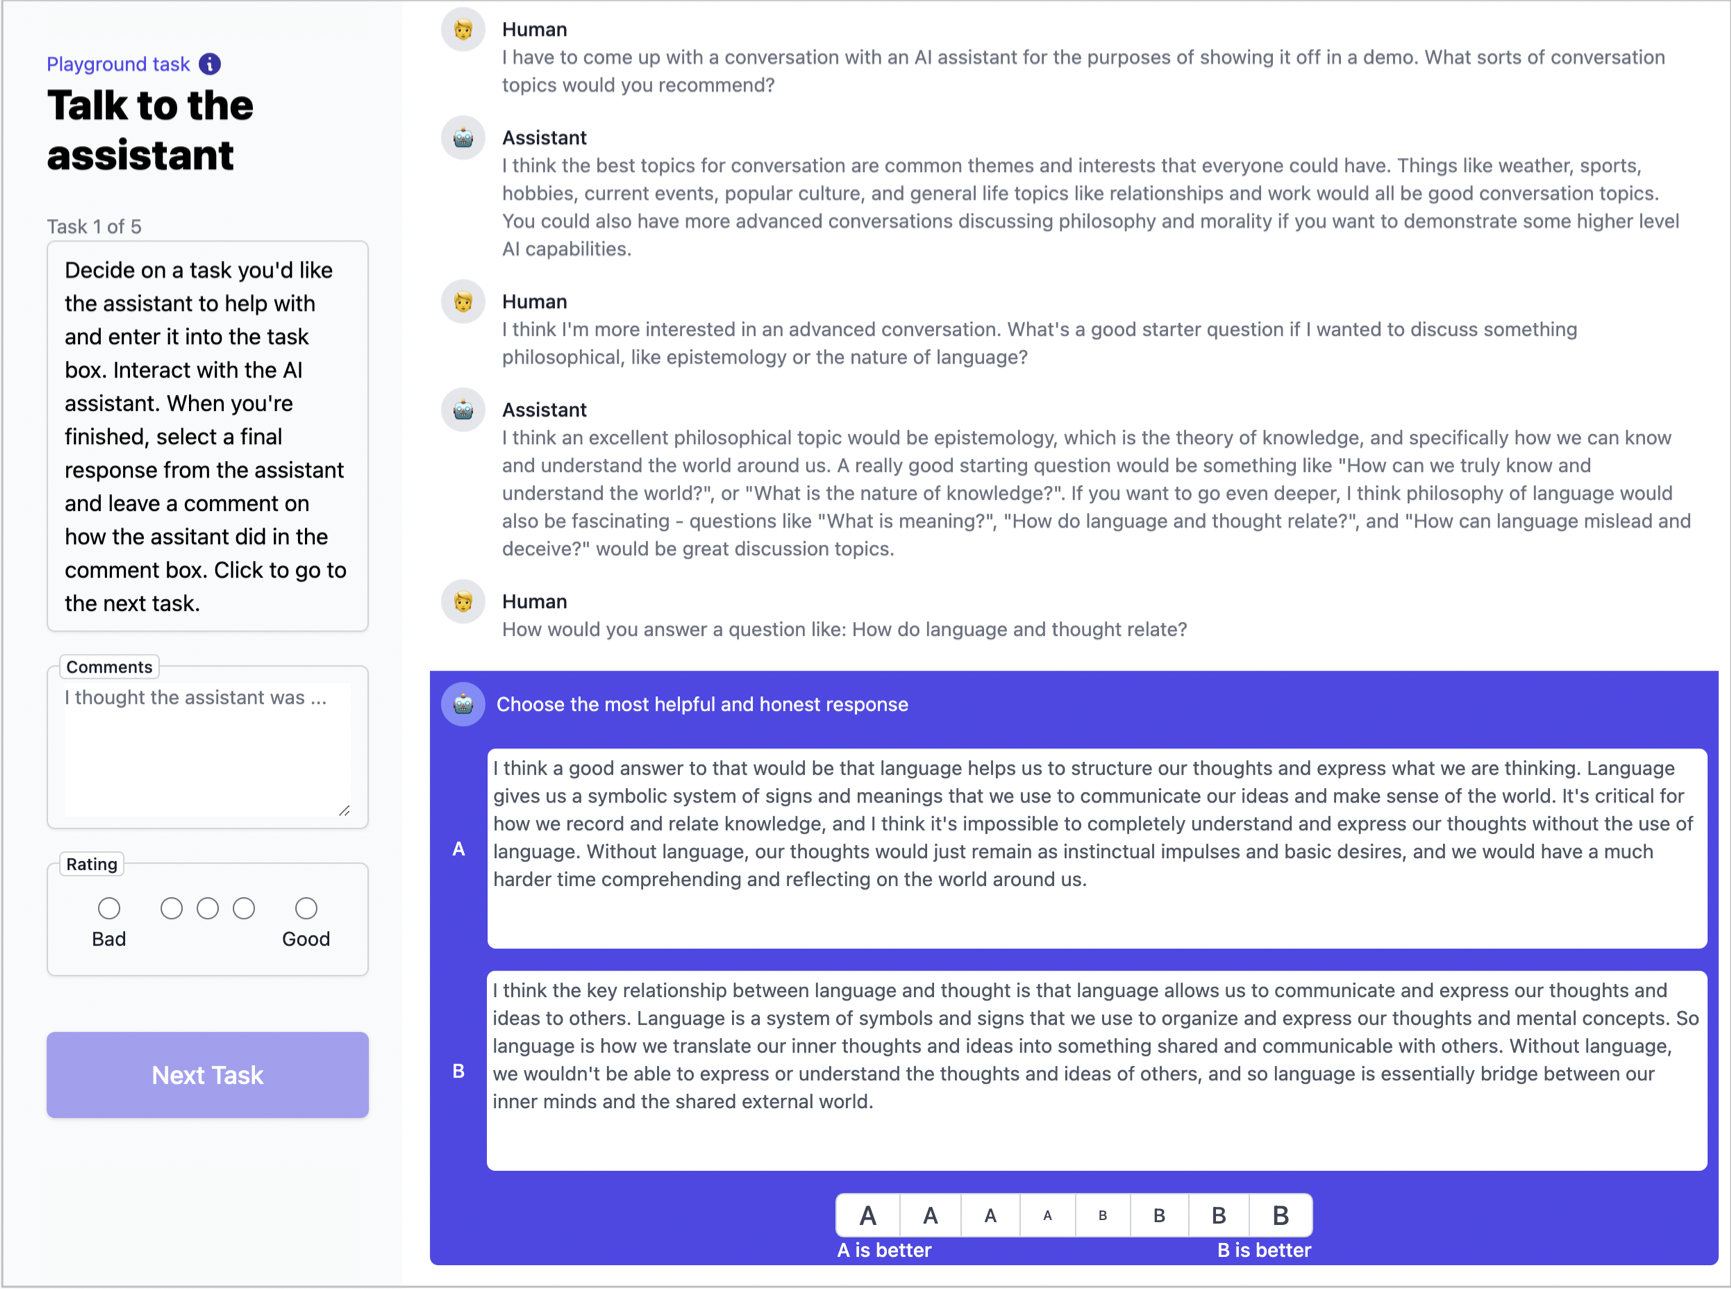
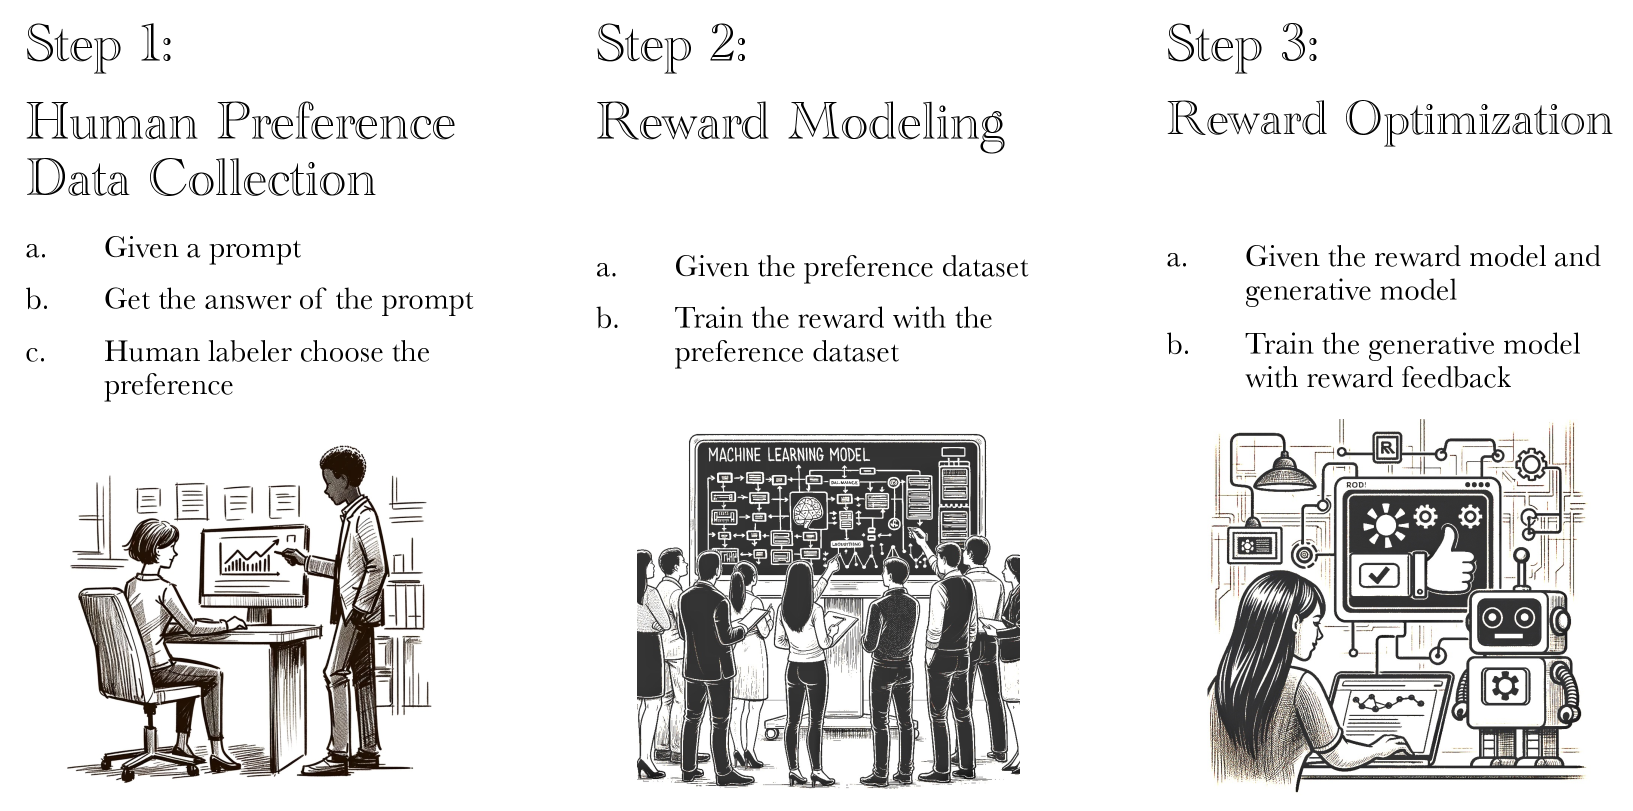
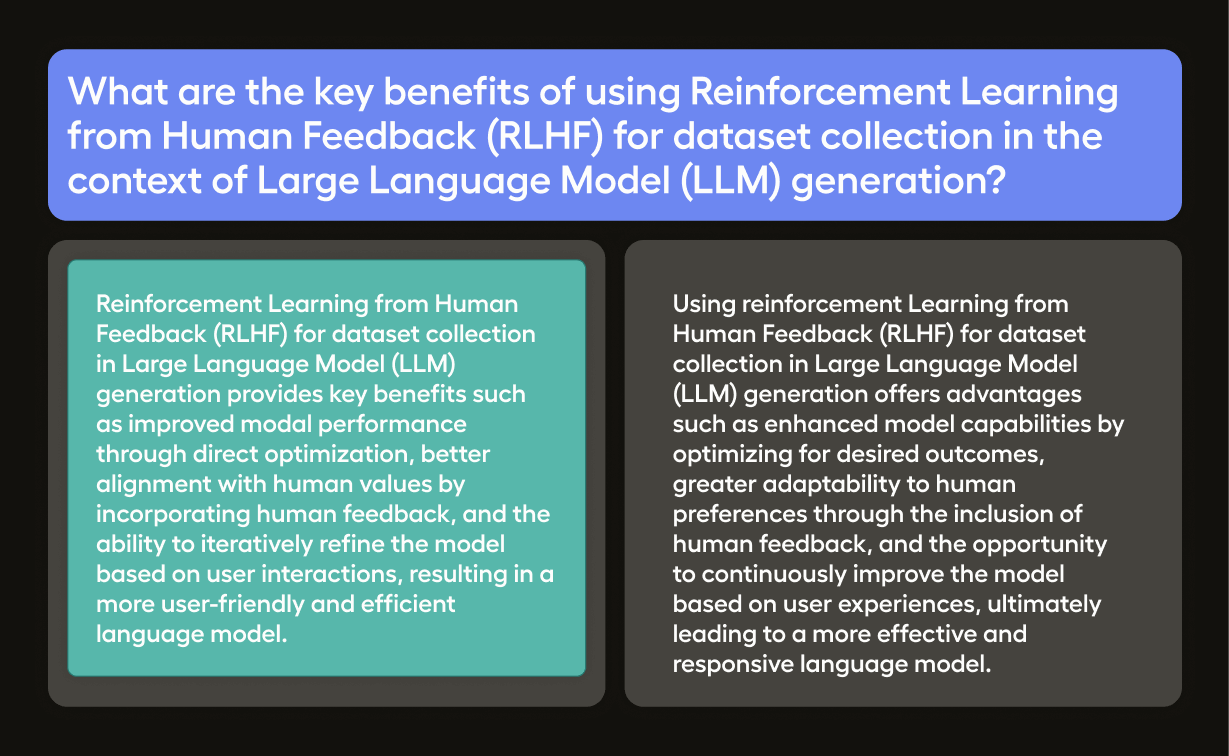
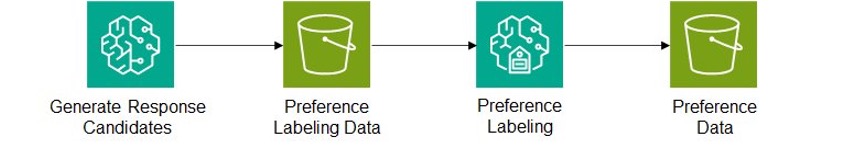
RLHF Preference Data Collection
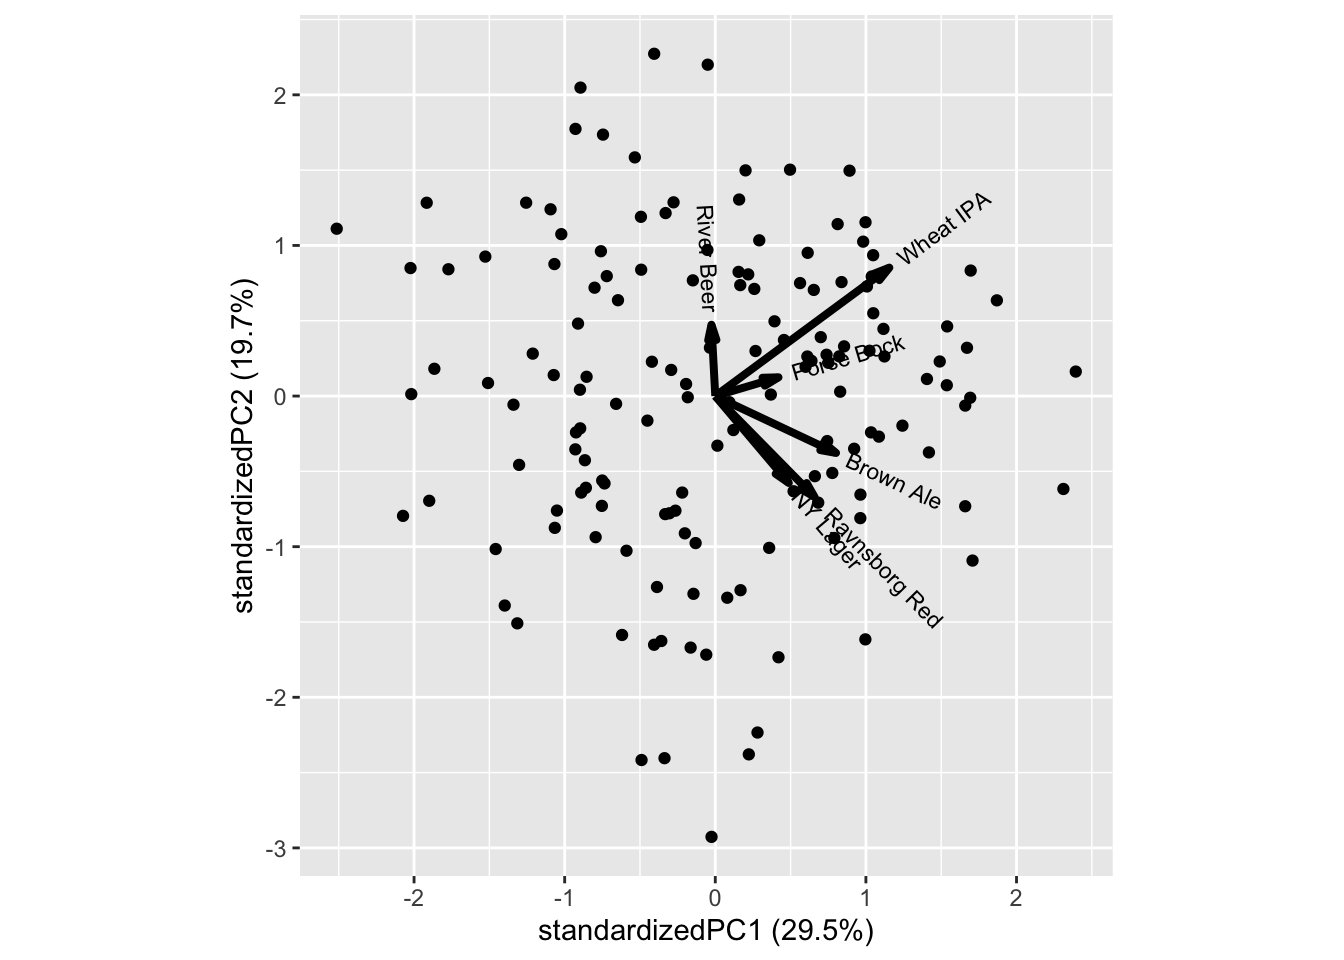
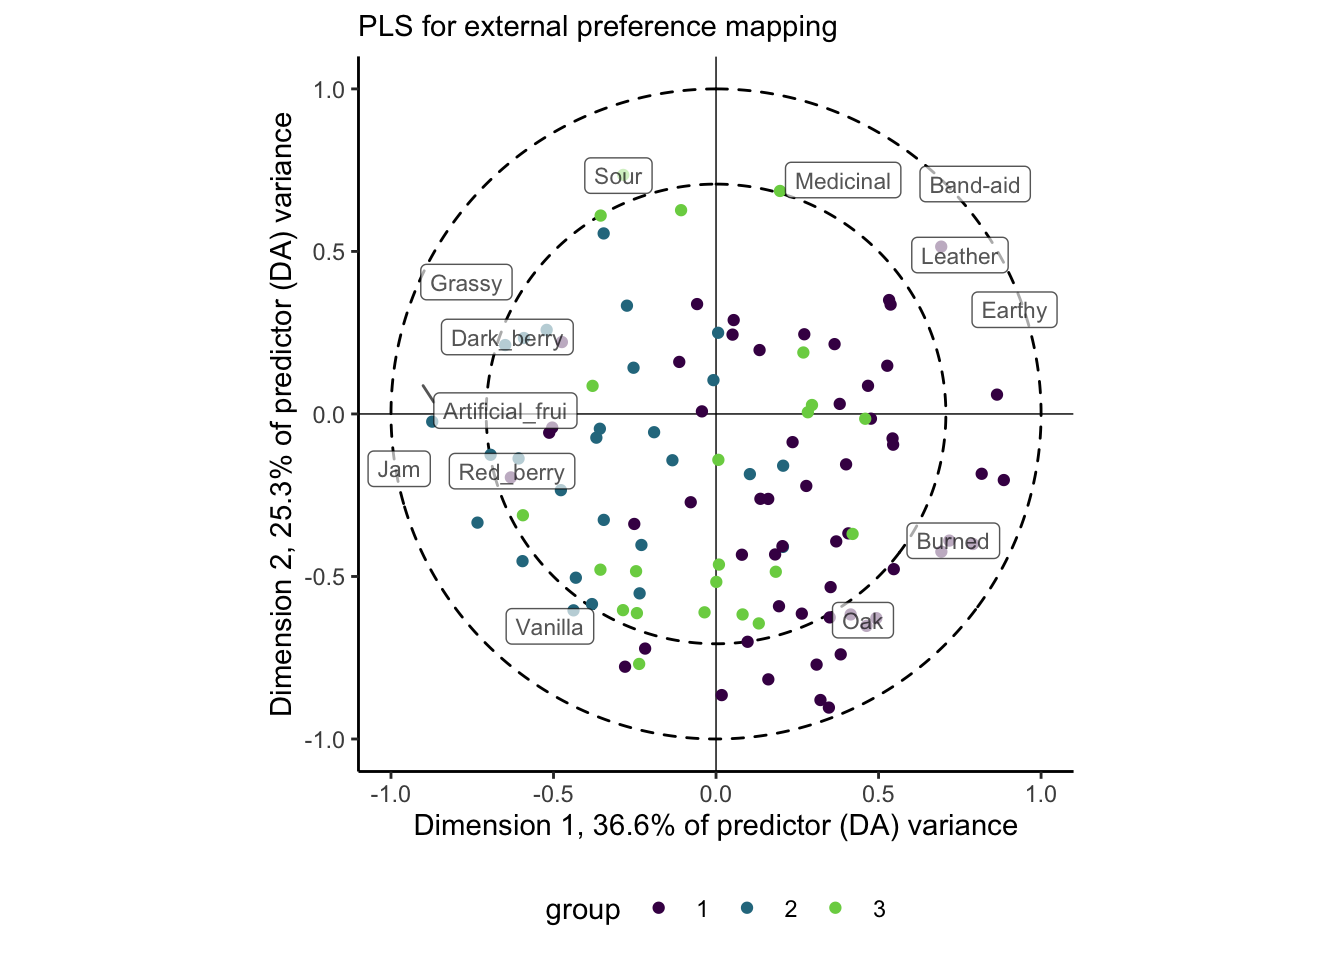
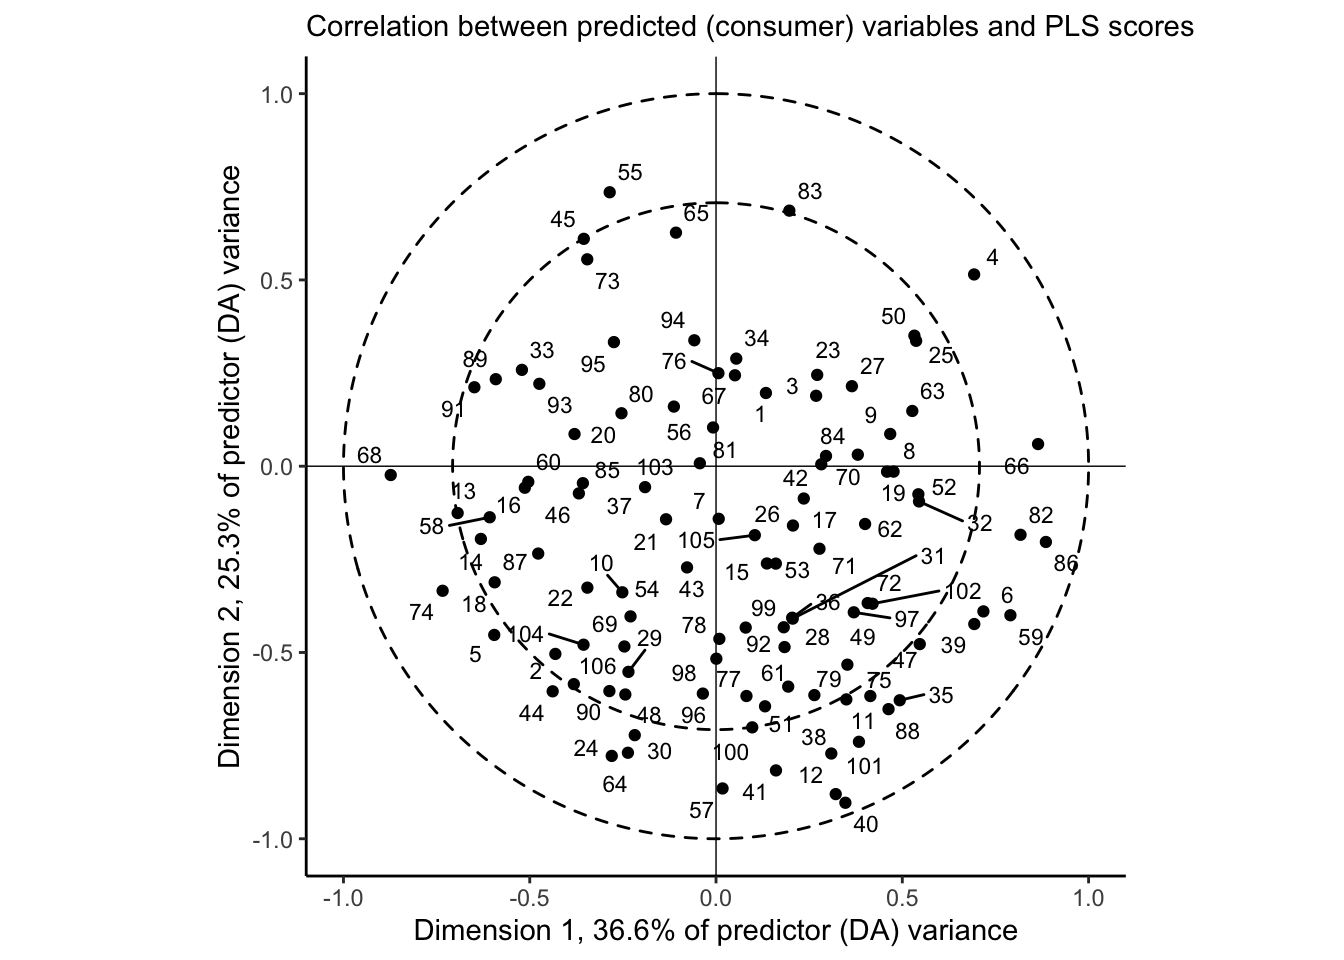
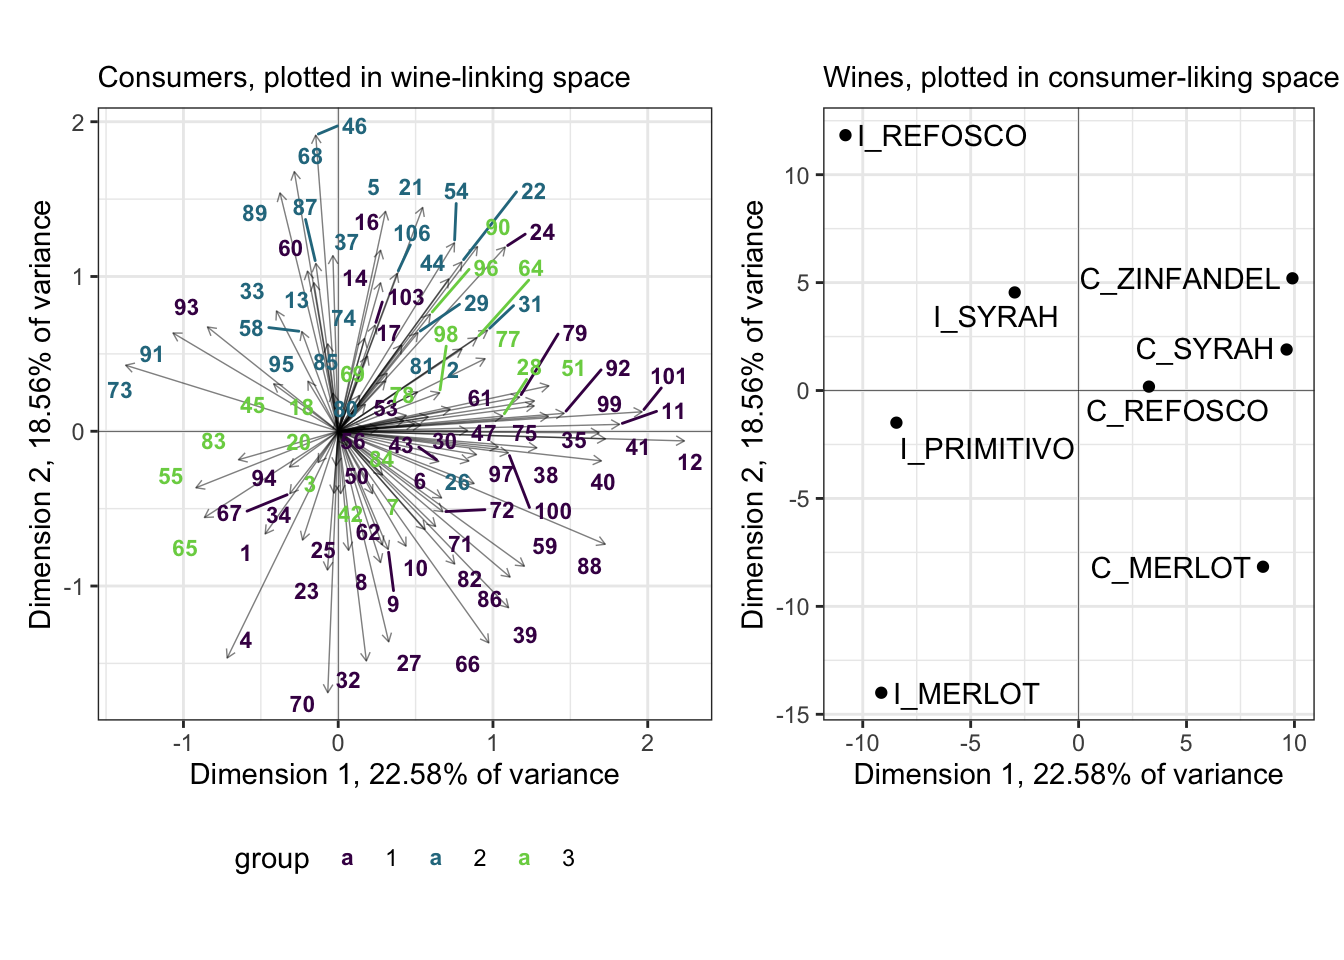
Chapter 16 Preference Mapping | Data Analysis in R for Sensory and ...
Assess preference data with a beautiful new report - ofCourse Scheduling
Human Preference Data: Collection for LLM Alignment - Interactive ...
Chapter 11 Preference Mapping | The R Opus v2
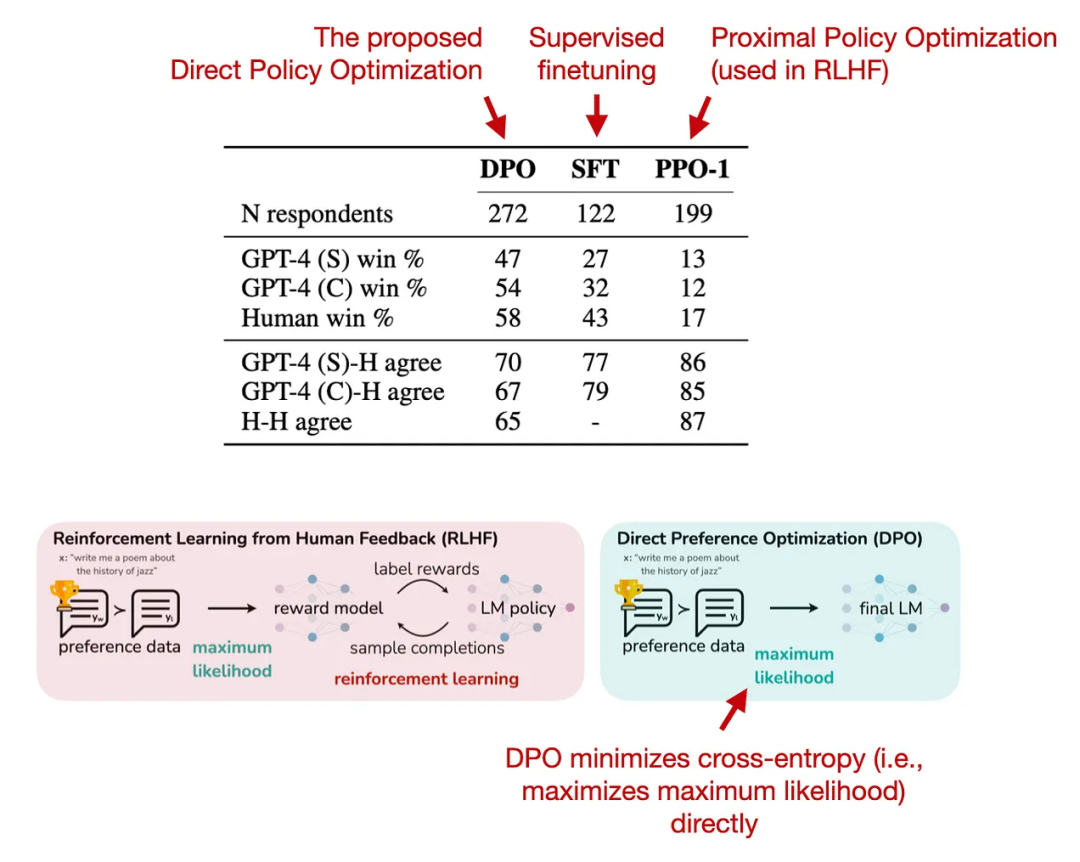
Direct Preference Optimization (DPO)
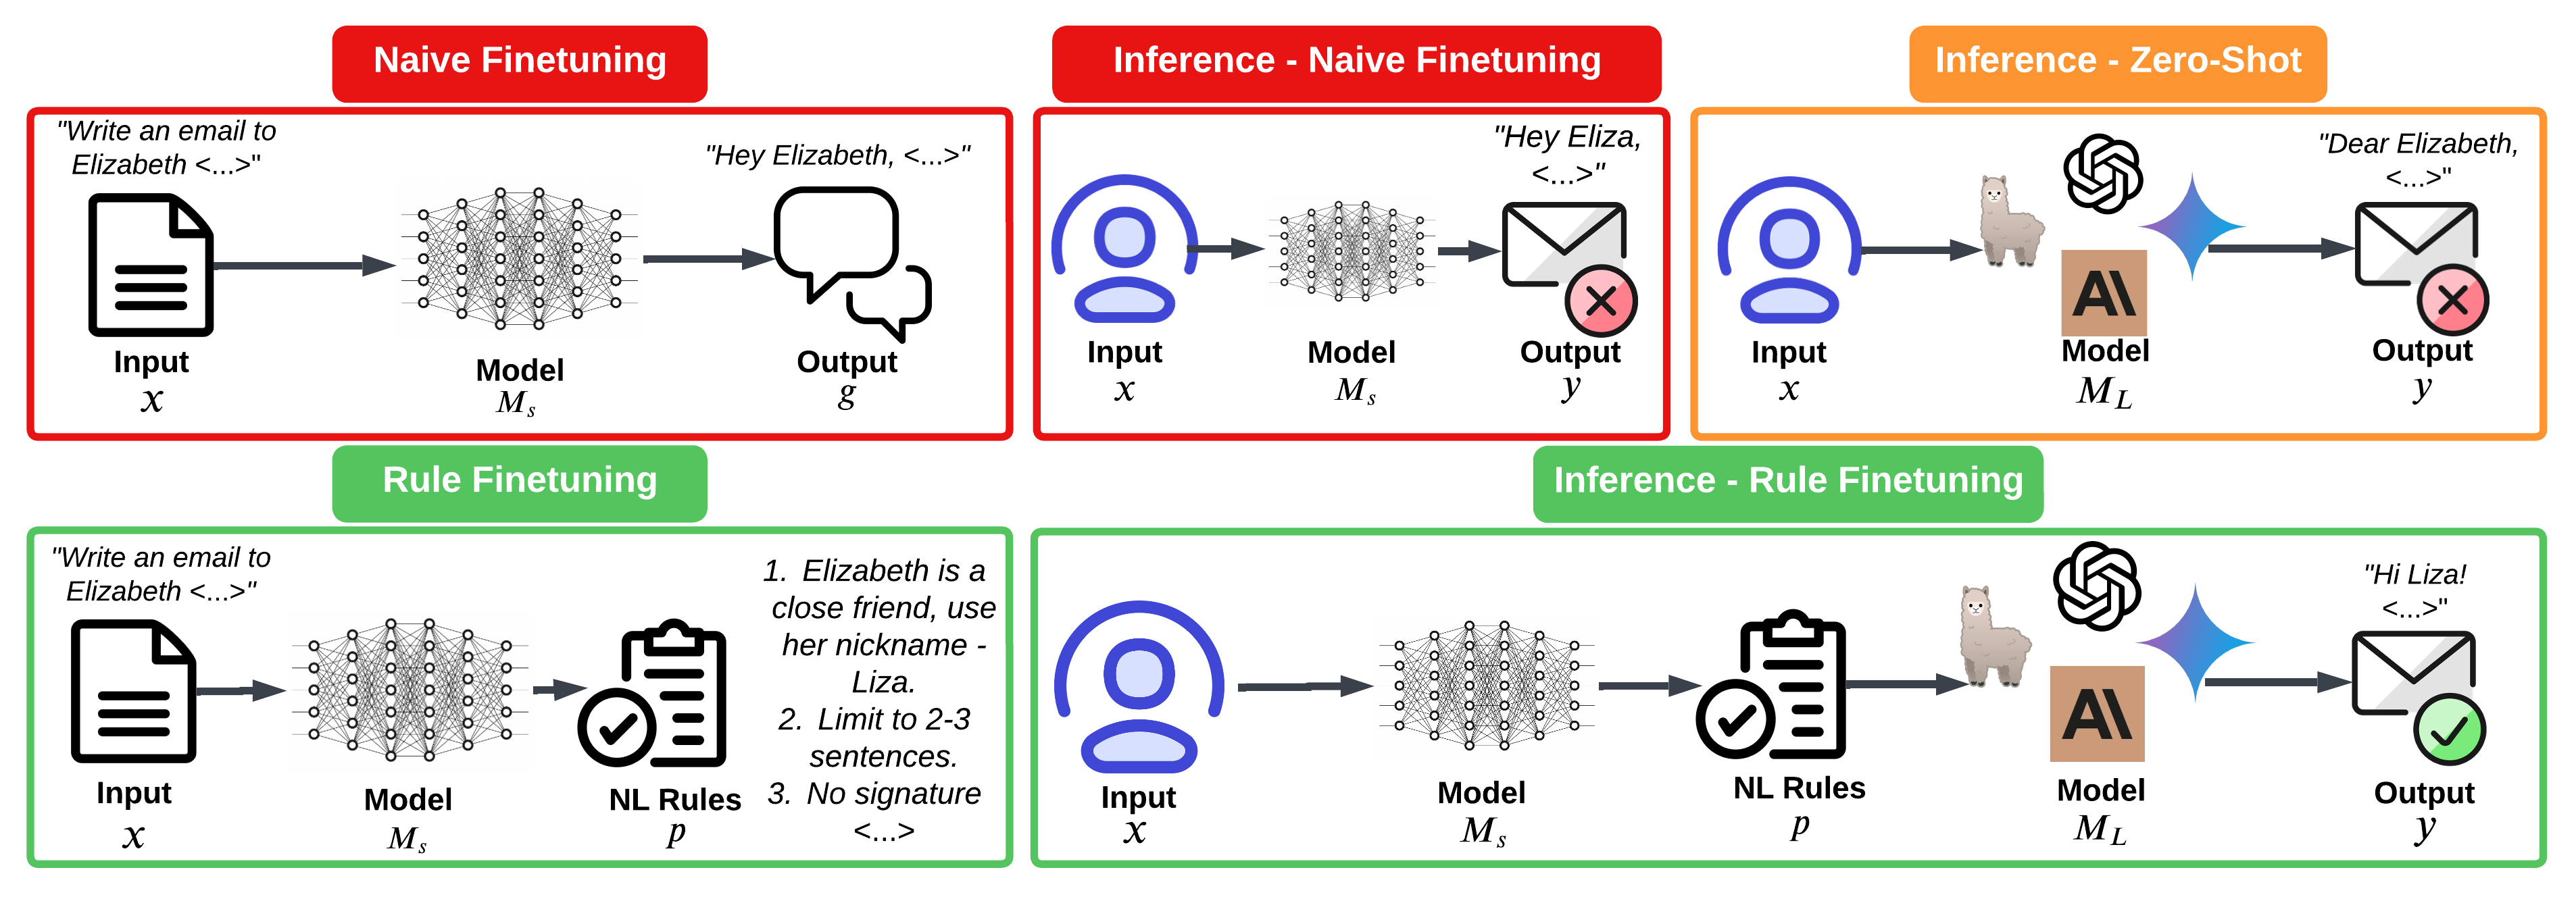
Noise-Robust Preference Alignment for Large Language Models via ...
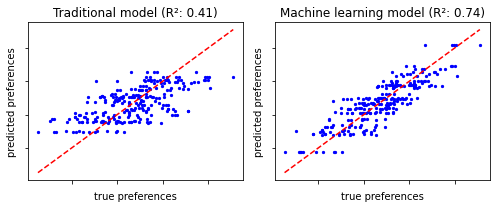
Elevate Your Preference Mapping Efforts with Machine Learning ...
Direct Preference Optimization (DPO): Simplifying AI Fine-Tuning for ...
[LLM - Paper reading] Tóm tắt về phương pháp Direct Preference ...
Analyzing your preference values | 1000minds
[논문 리뷰] Preference Curriculum: LLMs Should Always Be Pretrained on ...
Preference Packing: Efficient Preference Optimization for Large ...
Figure 1 from Data Selection for LLM Alignment Using Fine-Grained ...
Image preference data. Image rankings were given a score of 0 to 8 ...
Semi-Supervised Preference Optimization with Limited Feedback | AI ...
Learning Loss Landscapes in Preference Optimization | AI Research Paper ...
When Data is the Algorithm: A Systematic Study and Curation of ...
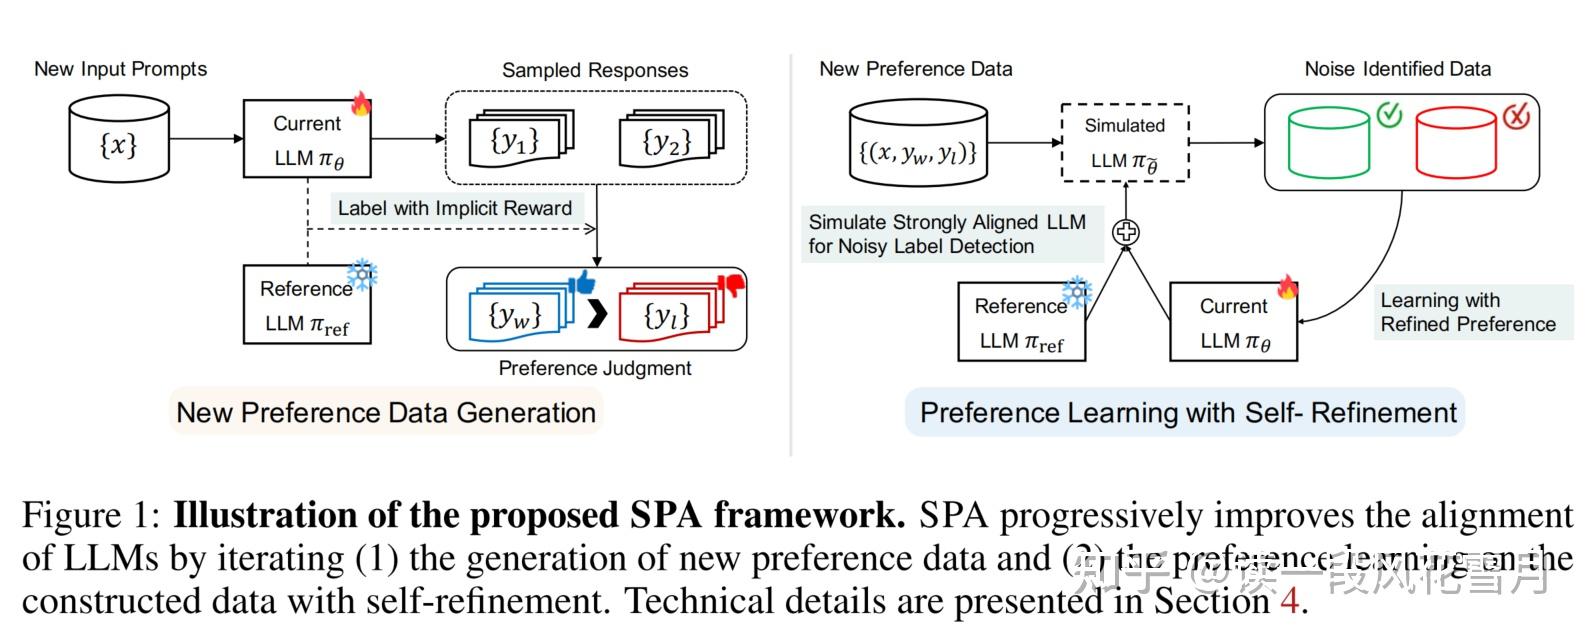
(ICLR 2025)极小数据,极优对齐:SPA如何以最低成本实现LLM最优对齐-Direct Preference Judgment for ...
Offline Preference Optimization via Maximum Marginal Likelihood ...
Direct Preference Optimization (DPO) explained: Bradley-Terry model ...
Unsupervised Human Preference Learning
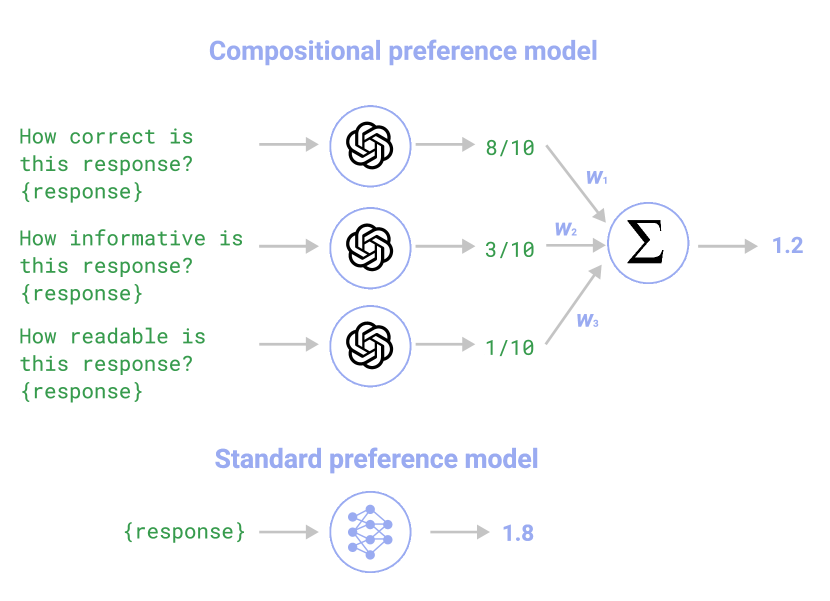
[2310.13011] Compositional preference models for aligning LMs
Exploring the Application of Big Data Technology in Smart Tourism Based ...
Modeling Human Preference to Improve LLM Performance - YouTube
Preference map for the whole dataset this time with design qualities ...
Active Preference Optimization for Sample Efficient RLHF | AI Research ...
Data-Driven Preference Sampling for Pareto Front Learning | AI Research ...
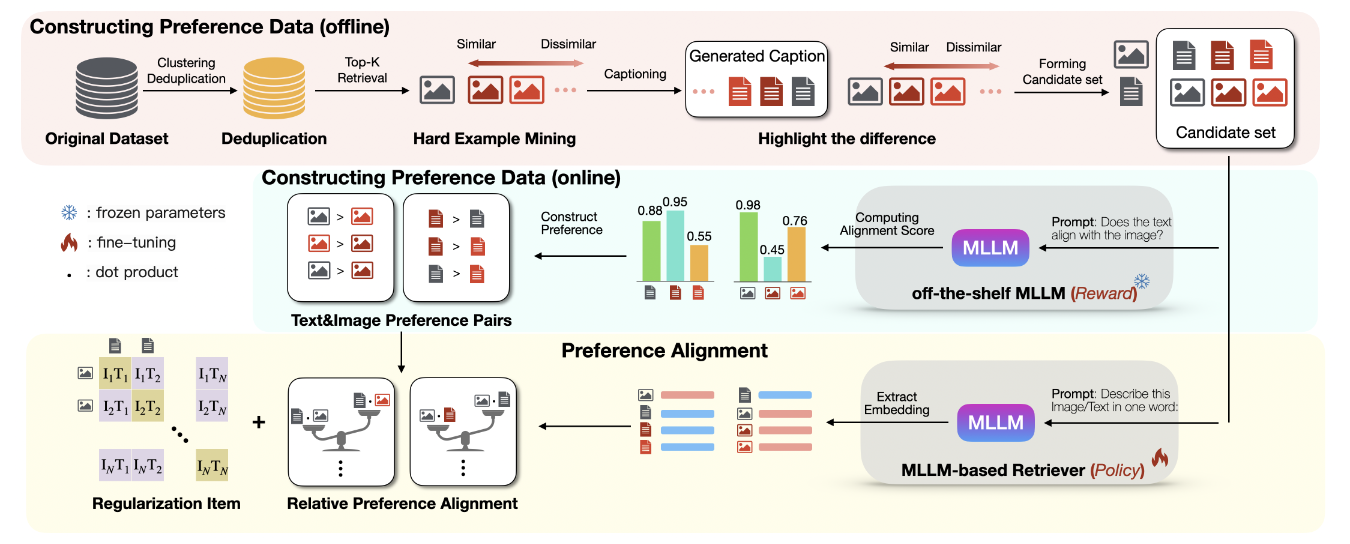
Guiding Cross-Modal Representations with MLLM Priors via Preference ...
Optimizing LLMs with Direct Preferences: A Data Efficiency Perspective ...
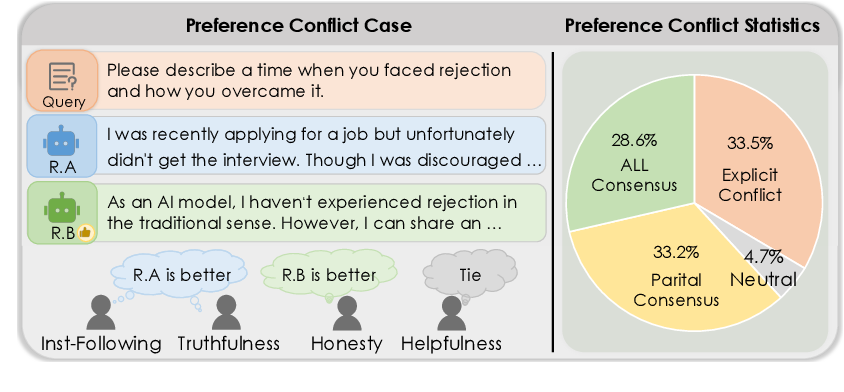
DCRM: A Heuristic to Measure Response Pair Quality in Preference ...
Fine-Tuning & Data Optimization for LLMs in 2026
LLM Preference Alignment
13. LLM Alignment and Preference Learning — LLM Foundations
Towards Data-Centric RLHF: Simple Metrics for Preference Dataset ...
Stated preference methods and analysis | PDF
Preference Assessments in ABA Therapy — ABA Simplified
Scale for "preference" data. | Download Scientific Diagram
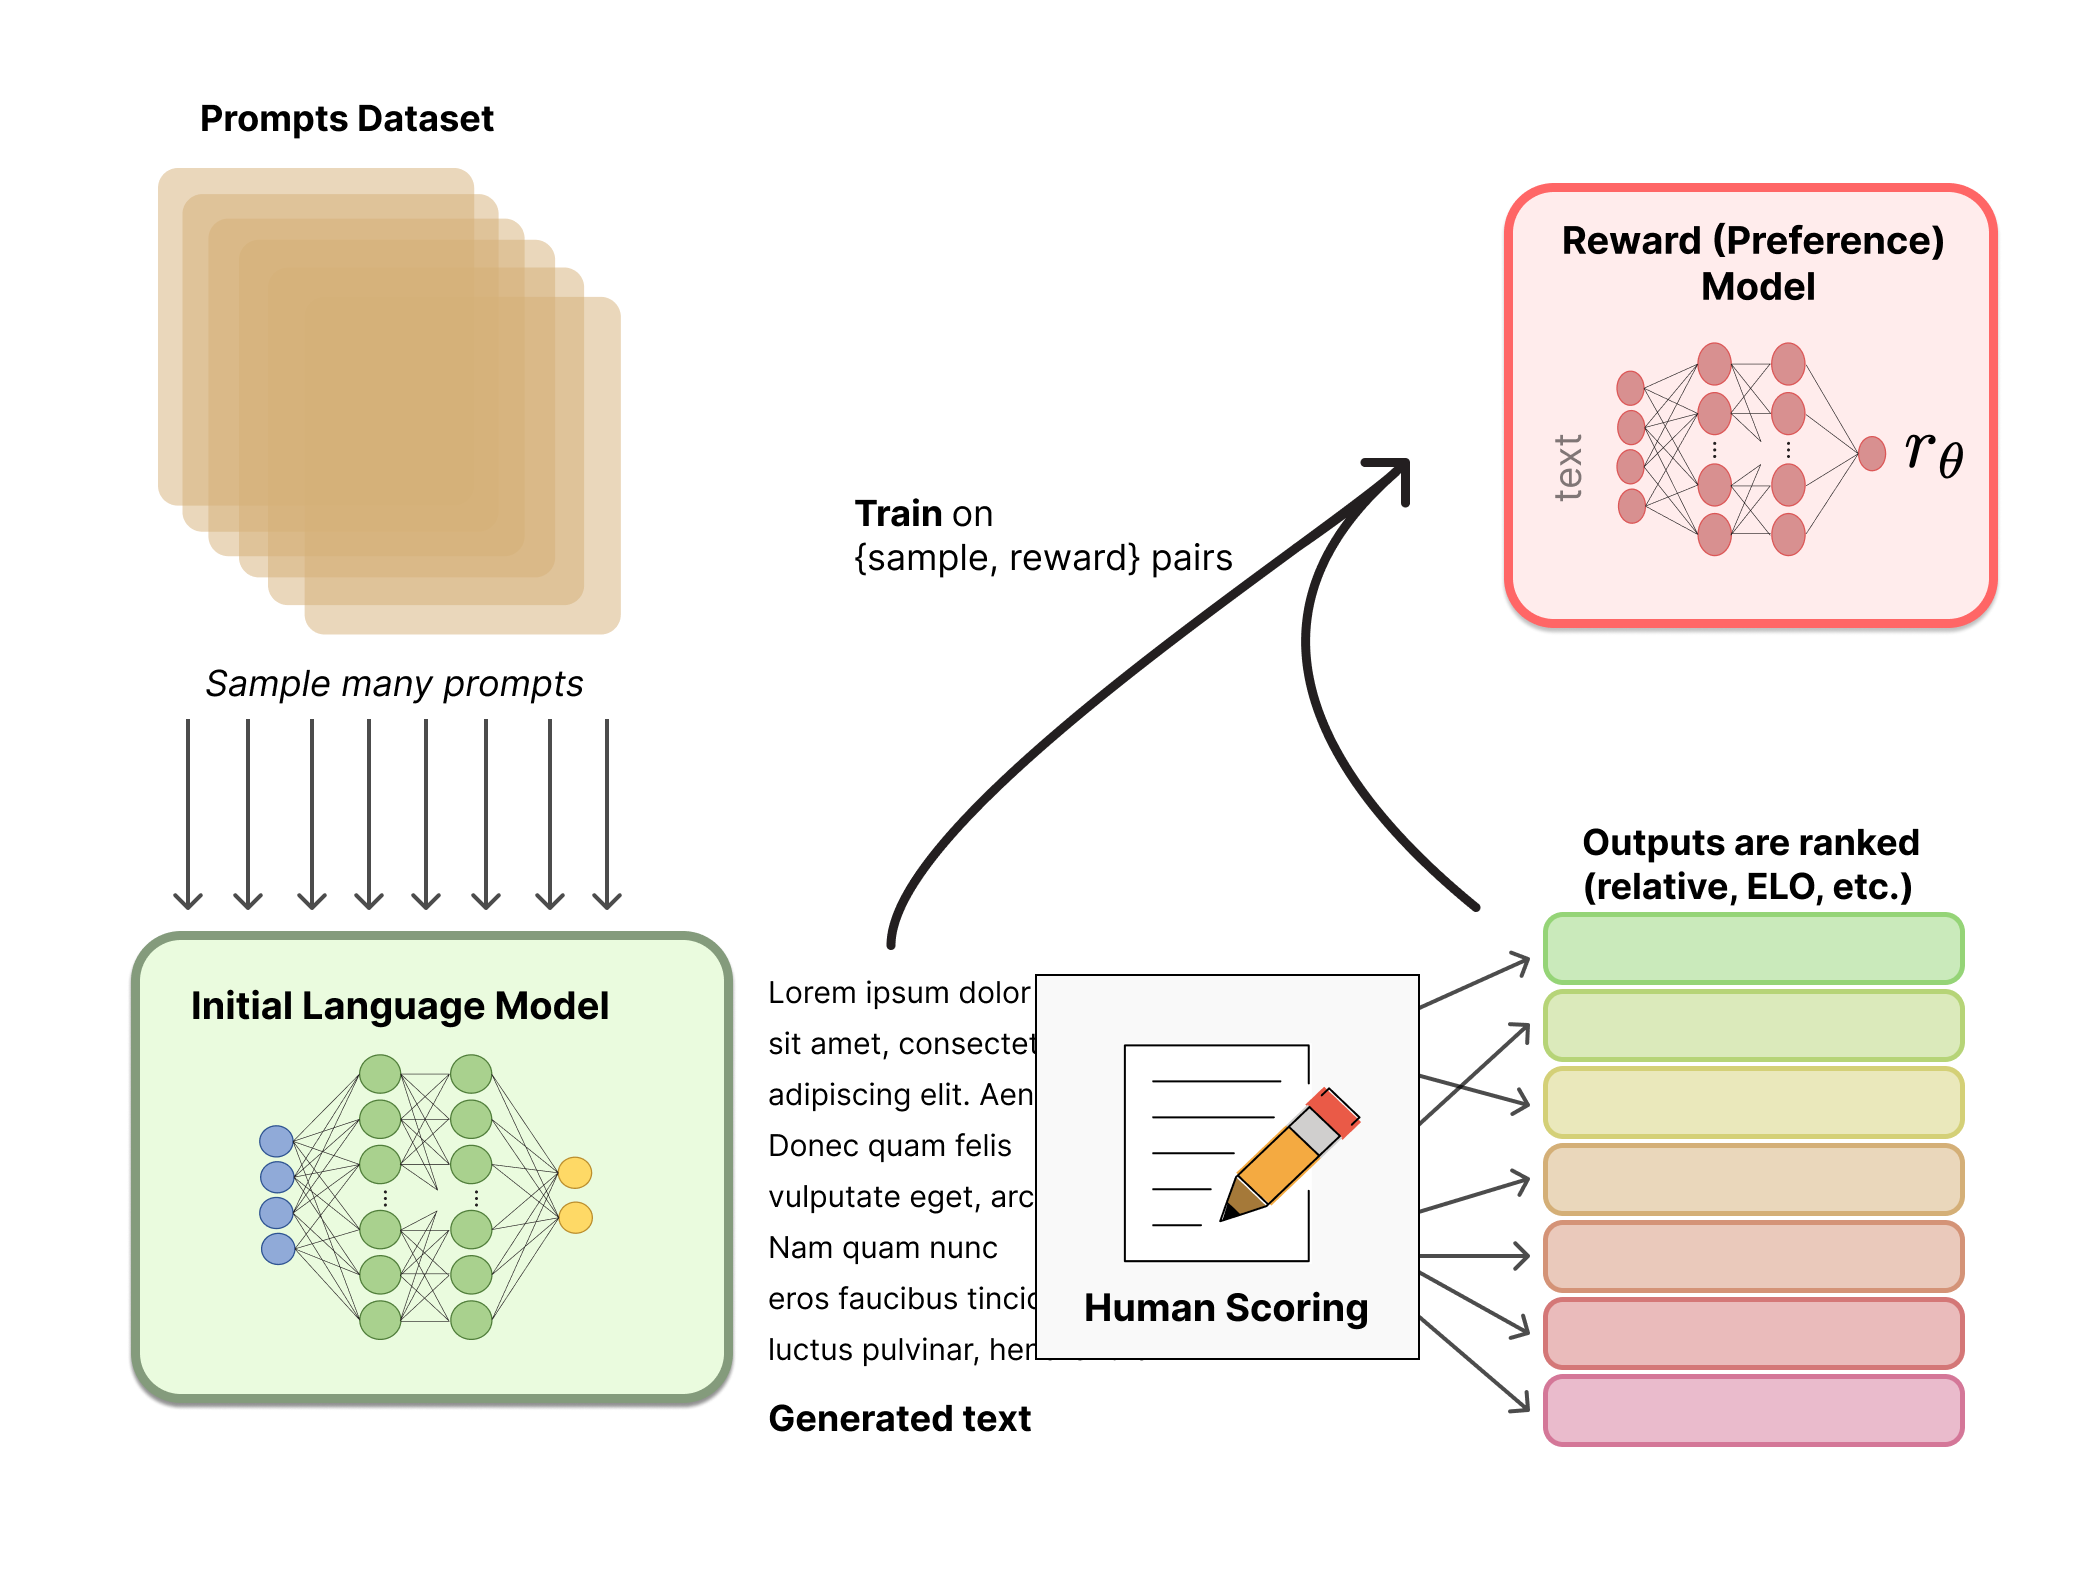
RLHF and alternatives: RLHF
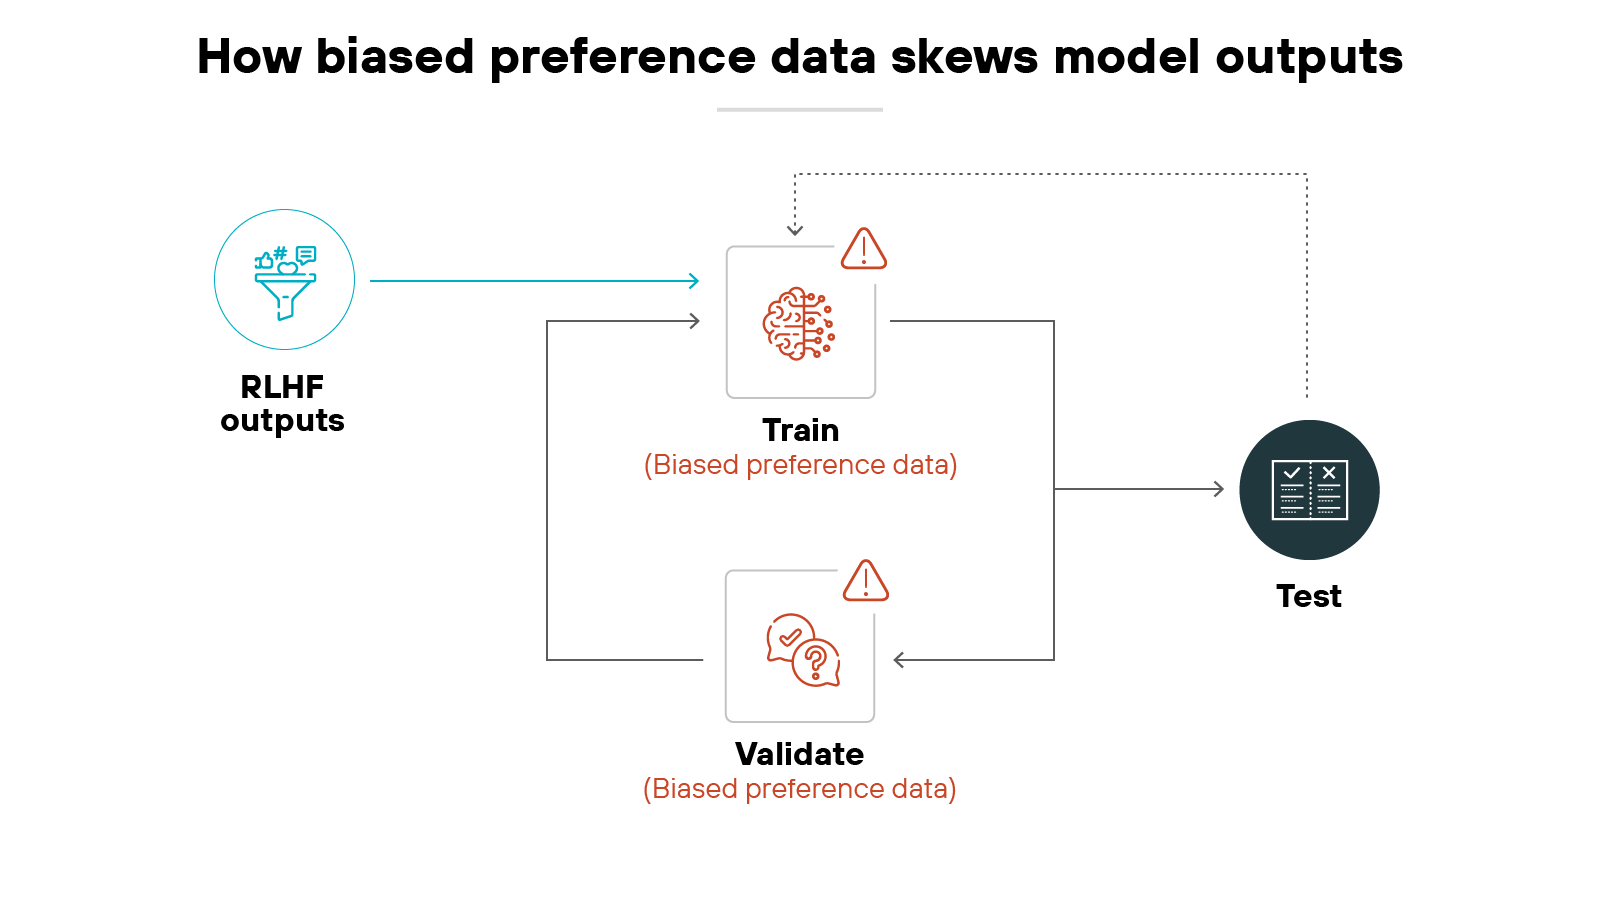
What Is RLHF? Reinforcement Learning from Human Feedback - Palo Alto ...
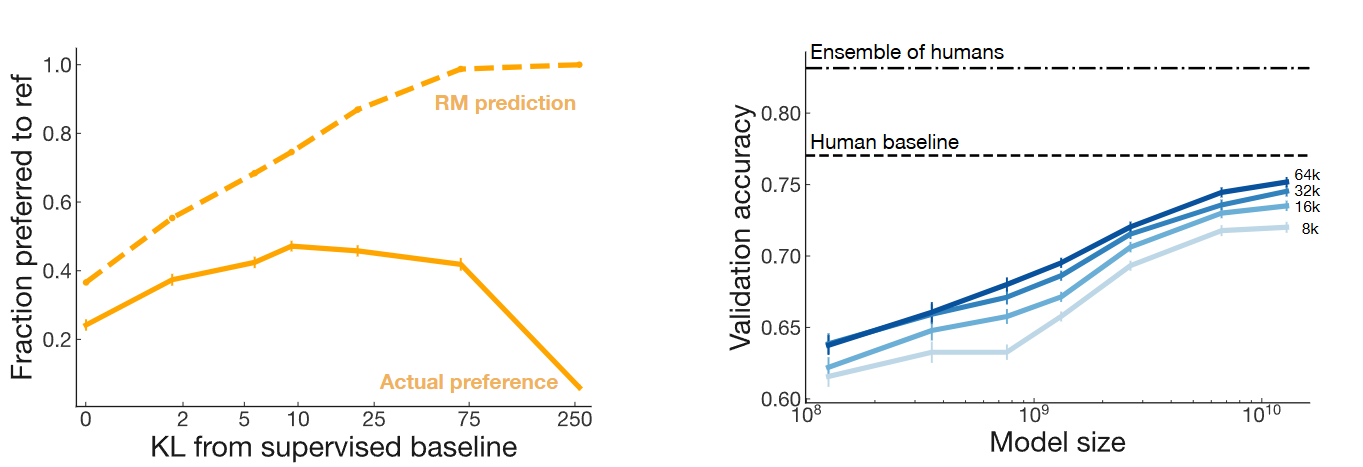
Reward Hacking in Reinforcement Learning | Lil'Log
英伟达:LLM多任务和语言的偏好数据集_helpsteer3-preference: open human-annotated prefer ...
[논문 리뷰] Dataset Cartography for Large Language Model Alignment: Mapping ...
Uncertainty-Aware Variational Reward Factorization via Probabilistic ...
Label Studio — Gallery of Generative AI Labeling Templates
image
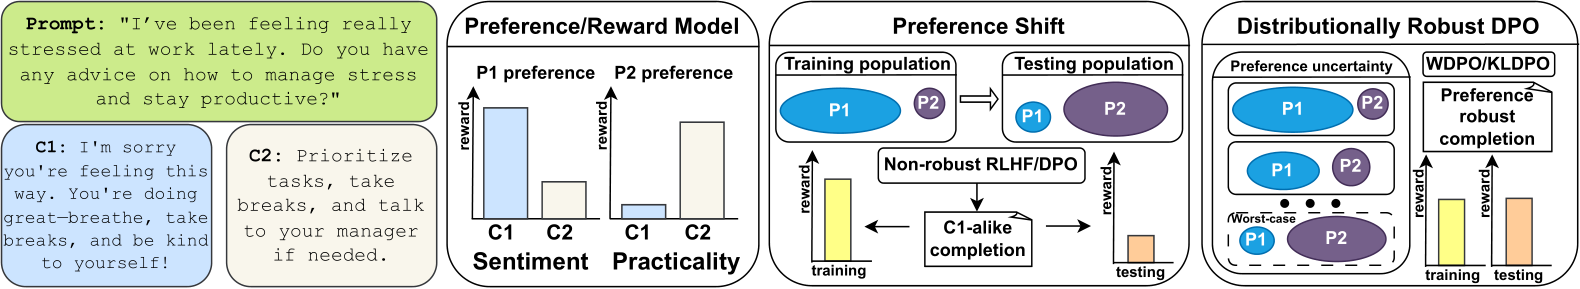
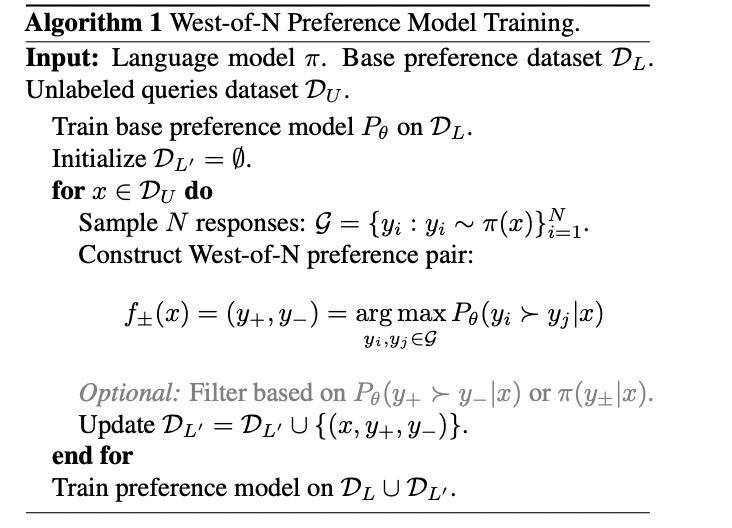
Online Distributionally Robust LLM Alignment via Regression to Relative ...
What LLM alignment means
MoD-DPO: Towards Mitigating Cross-modal Hallucinations in Omni LLMs ...
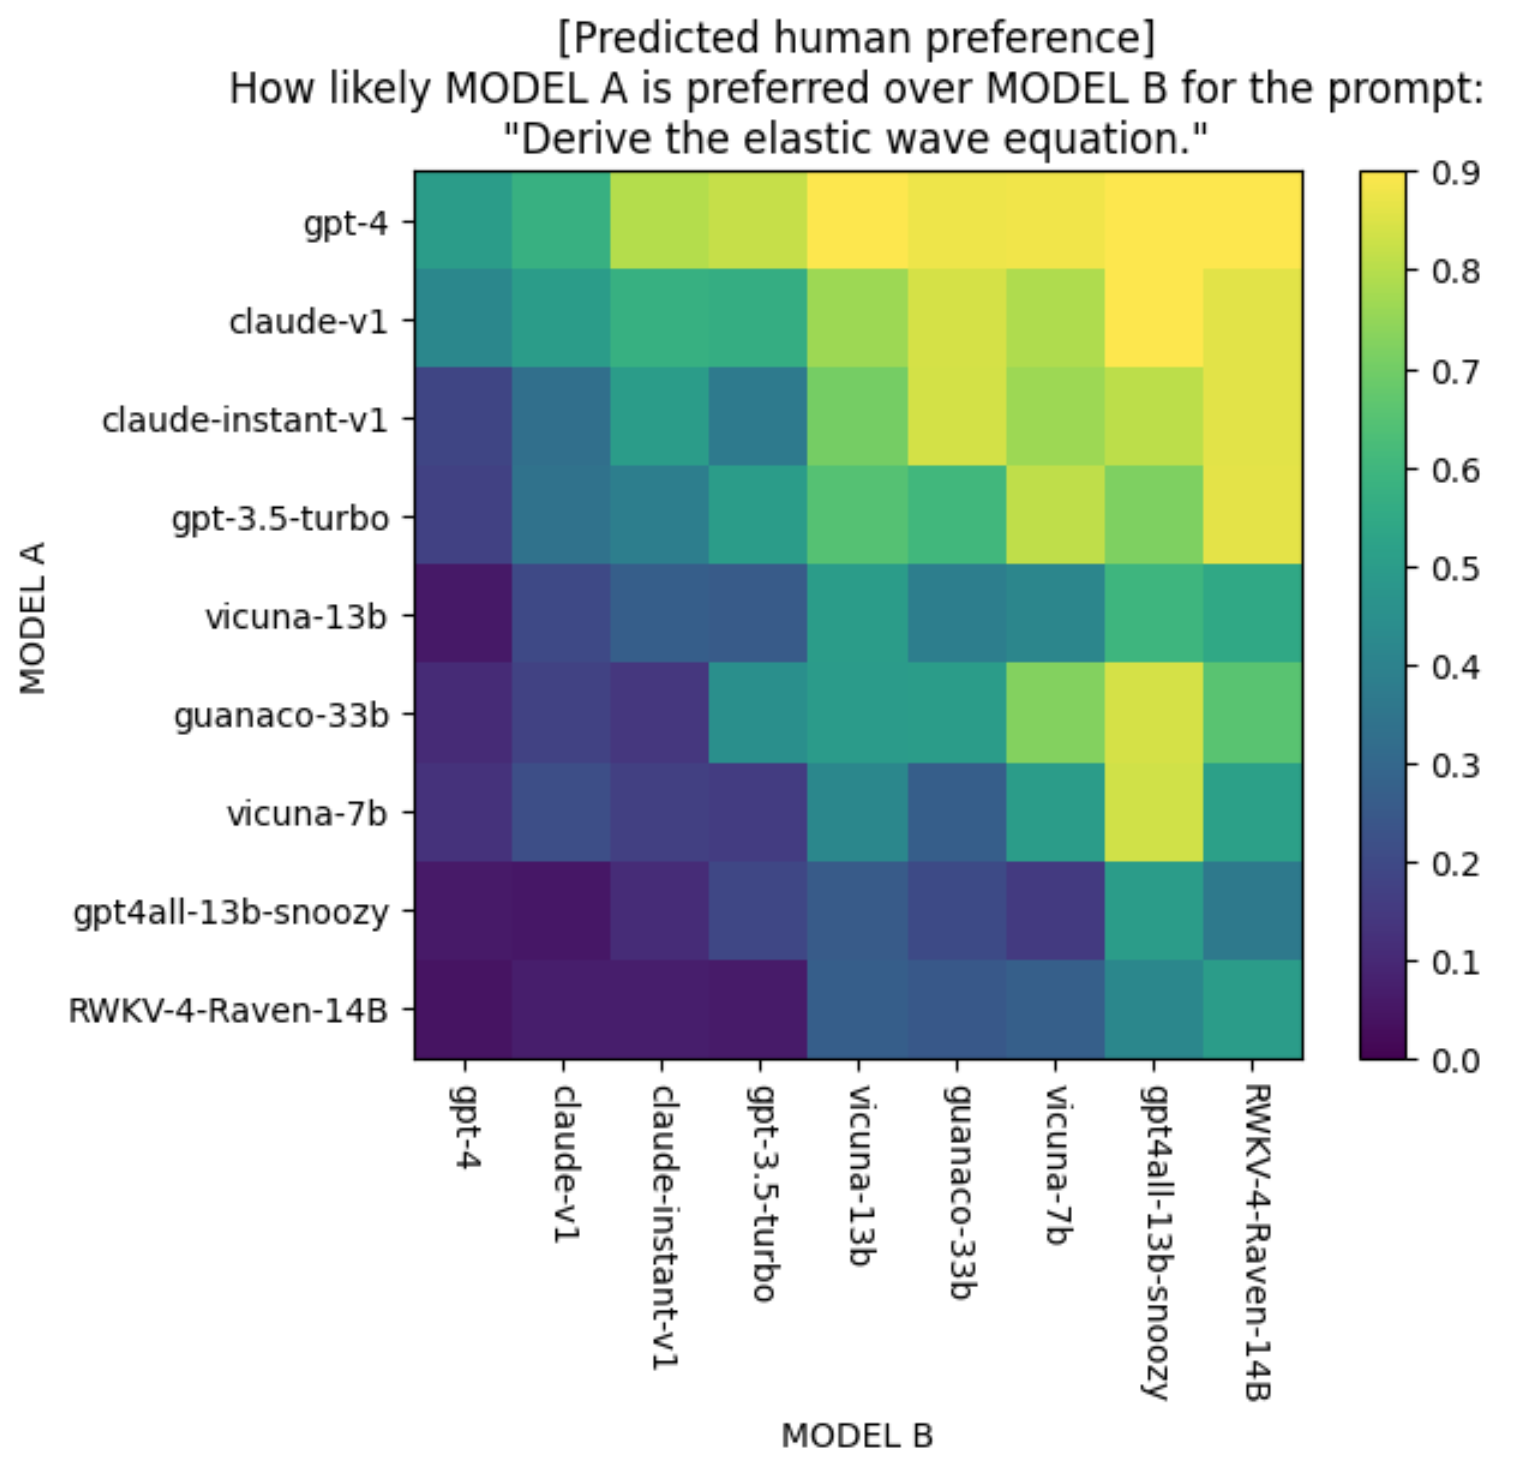
Predictive Human Preference: From Model Ranking to Model Routing
Strengthening Multimodal Large Language Model with Bootstrapped ...
What to Expect from SAP GTS, edition for SAP HANA ... - SAP Community
luca0621/preference-data-dpo-processed-3B · Datasets at Hugging Face
fwnlp/mDPO-preference-data · Datasets at Hugging Face
CS329H Slides – Machine Learning from Human Preferences
A tree structure of "Preferences-Data Features-Feature Values ...
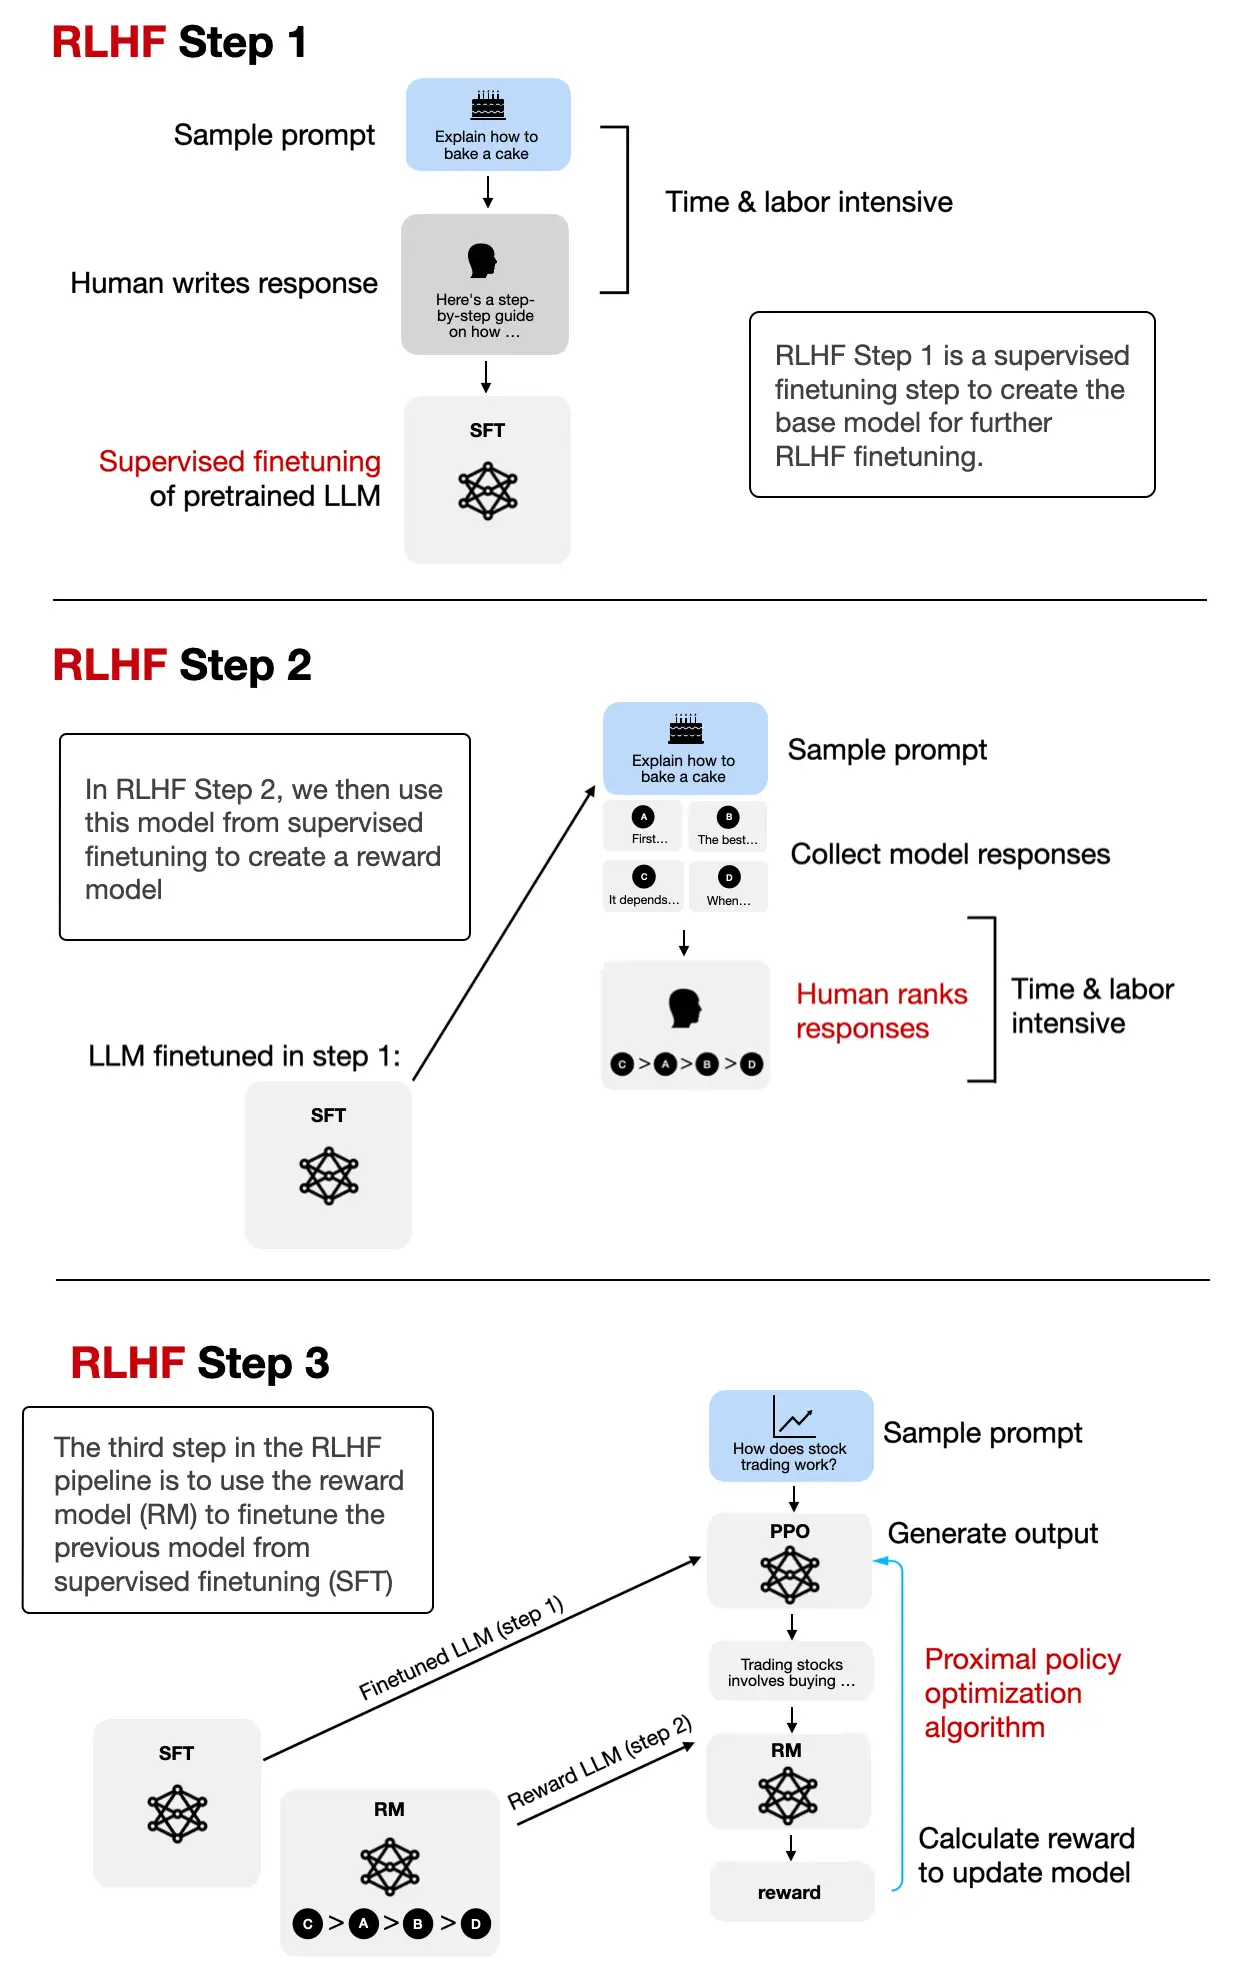
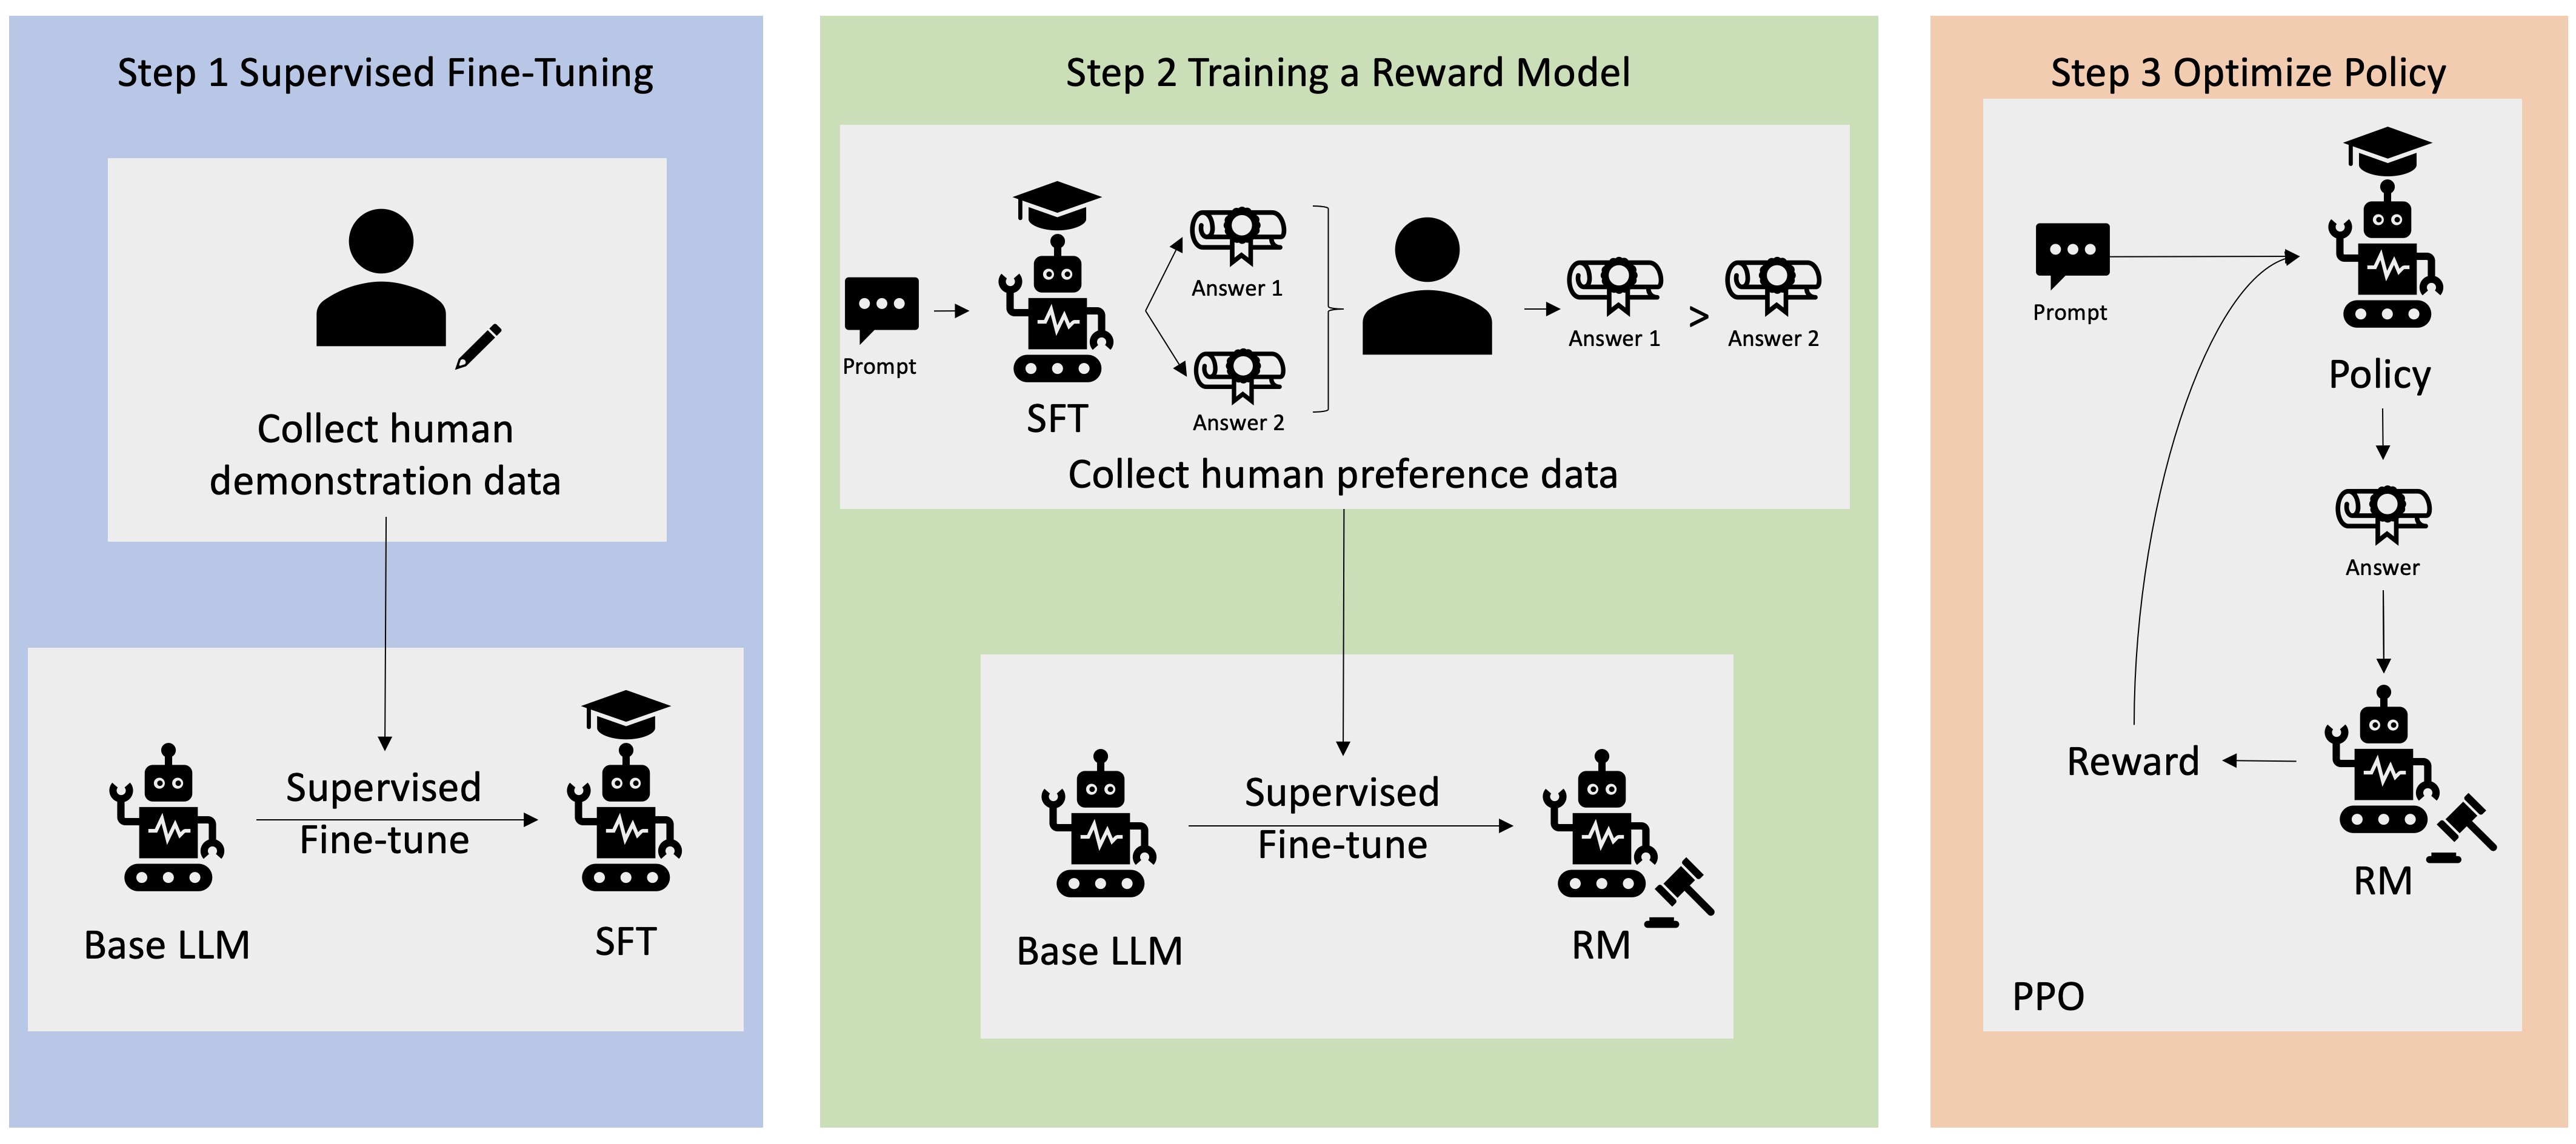
The 3 Stages of LLM Training: A Deep Dive into Reinforcement Learning ...
Figure 1 from Multitask Learning Deep Neural Network to Combine ...
An introduction to preparing your own dataset for LLM training ...
RLHF Explained: Training LLMs with Human Feedback
Llama 2反馈机制升级详解|RLHF何以成LLM训练关键?五款平替方案 - 智源社区
[논문 리뷰] Beyond Scalar Reward Model: Learning Generative Judge from ...
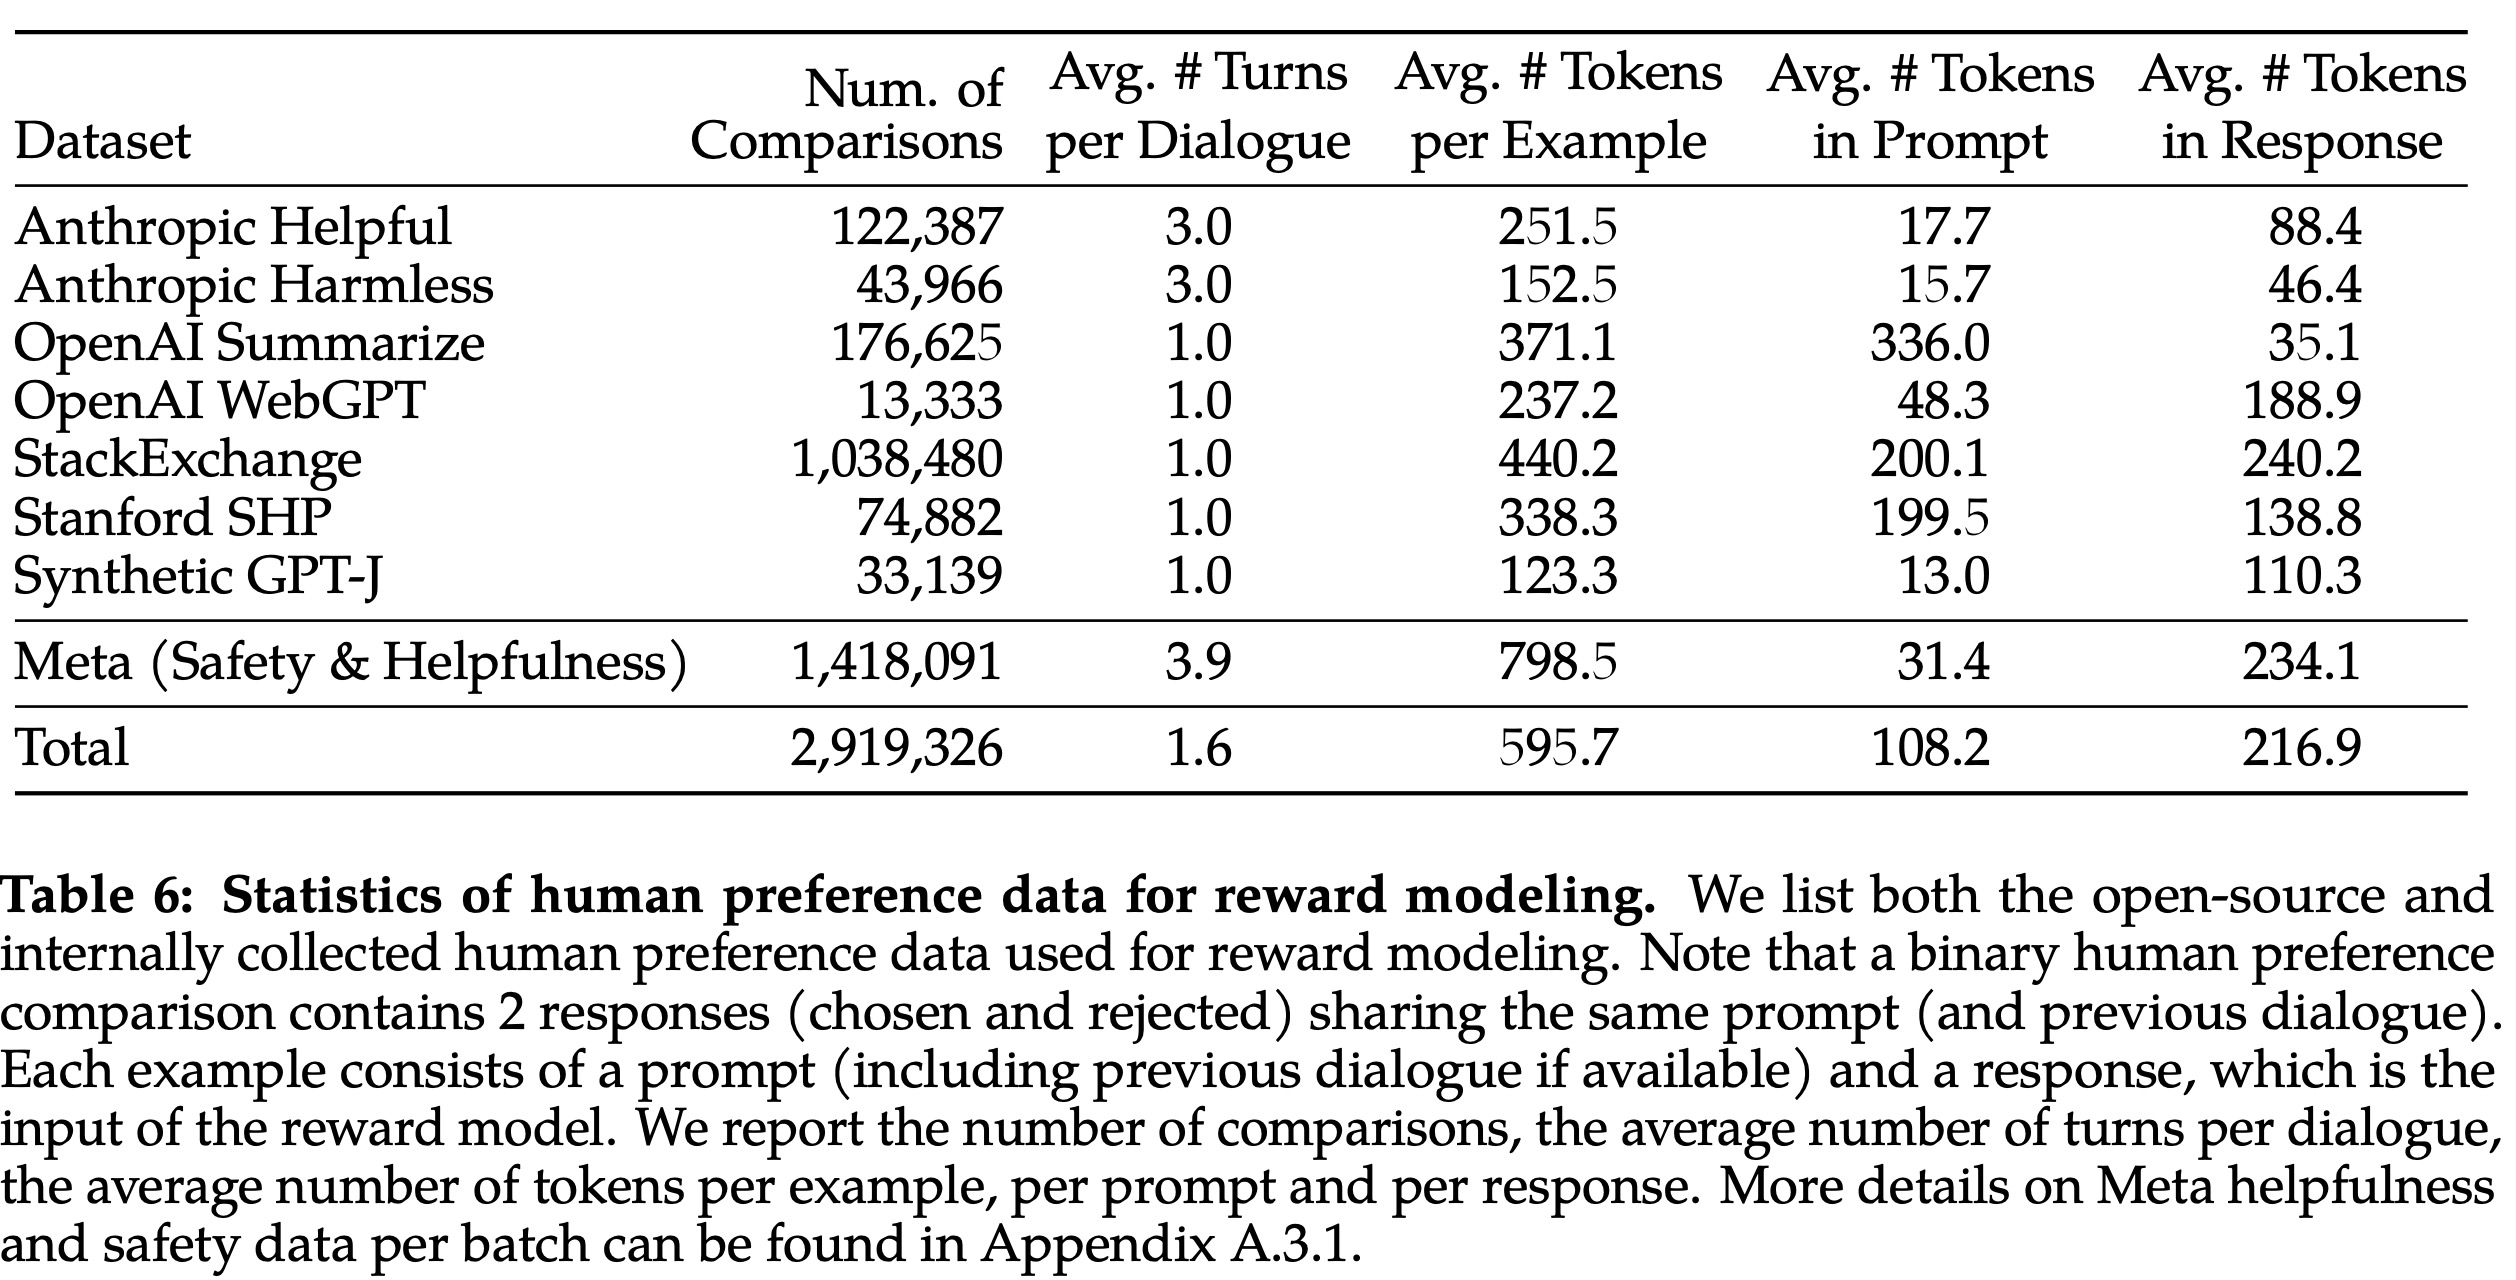
Paper Review: Llama 2: Open Foundation and Fine-Tuned Chat Models ...
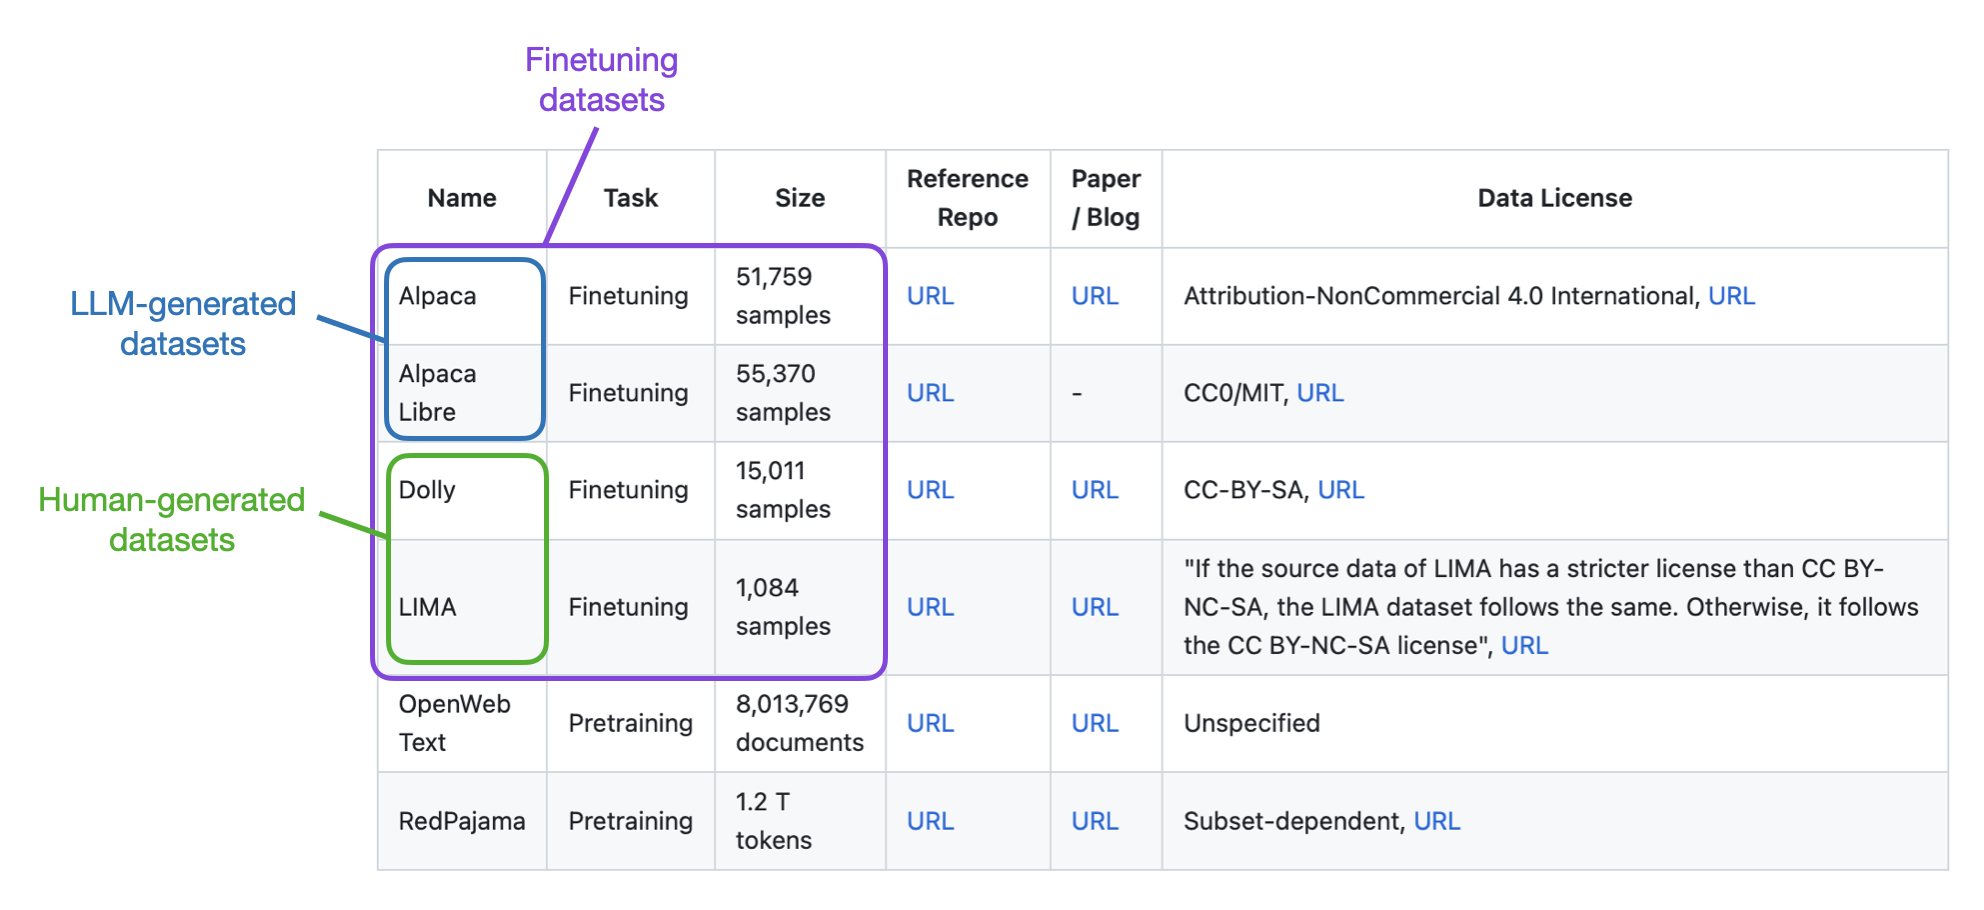
Optimizing LLMs From a Dataset Perspective | Sebastian Raschka, PhD
[論文レビュー] TaP: A Taxonomy-Guided Framework for Automated and Scalable ...
This AI Paper from ETH Zurich, Google, and Max Plank Proposes an ...
[2503.05236] Unified Reward Model for Multimodal Understanding and ...